
502 和 504 都可能出现在反向代理链路中,但处理方向不能只由状态码决定。浏览器看到错误时,真正生成响应的可能是 CDN、Nginx,也可能是更内层的网关。有效排查应把同一时间、同一路径的访问日志、错误日志和应用日志串起来,再决定是否改配置。
RootGS 技术编辑 · 2026 年 9 月 17 日 · 原创排障指南;命令中的目标和路径需按实际环境替换
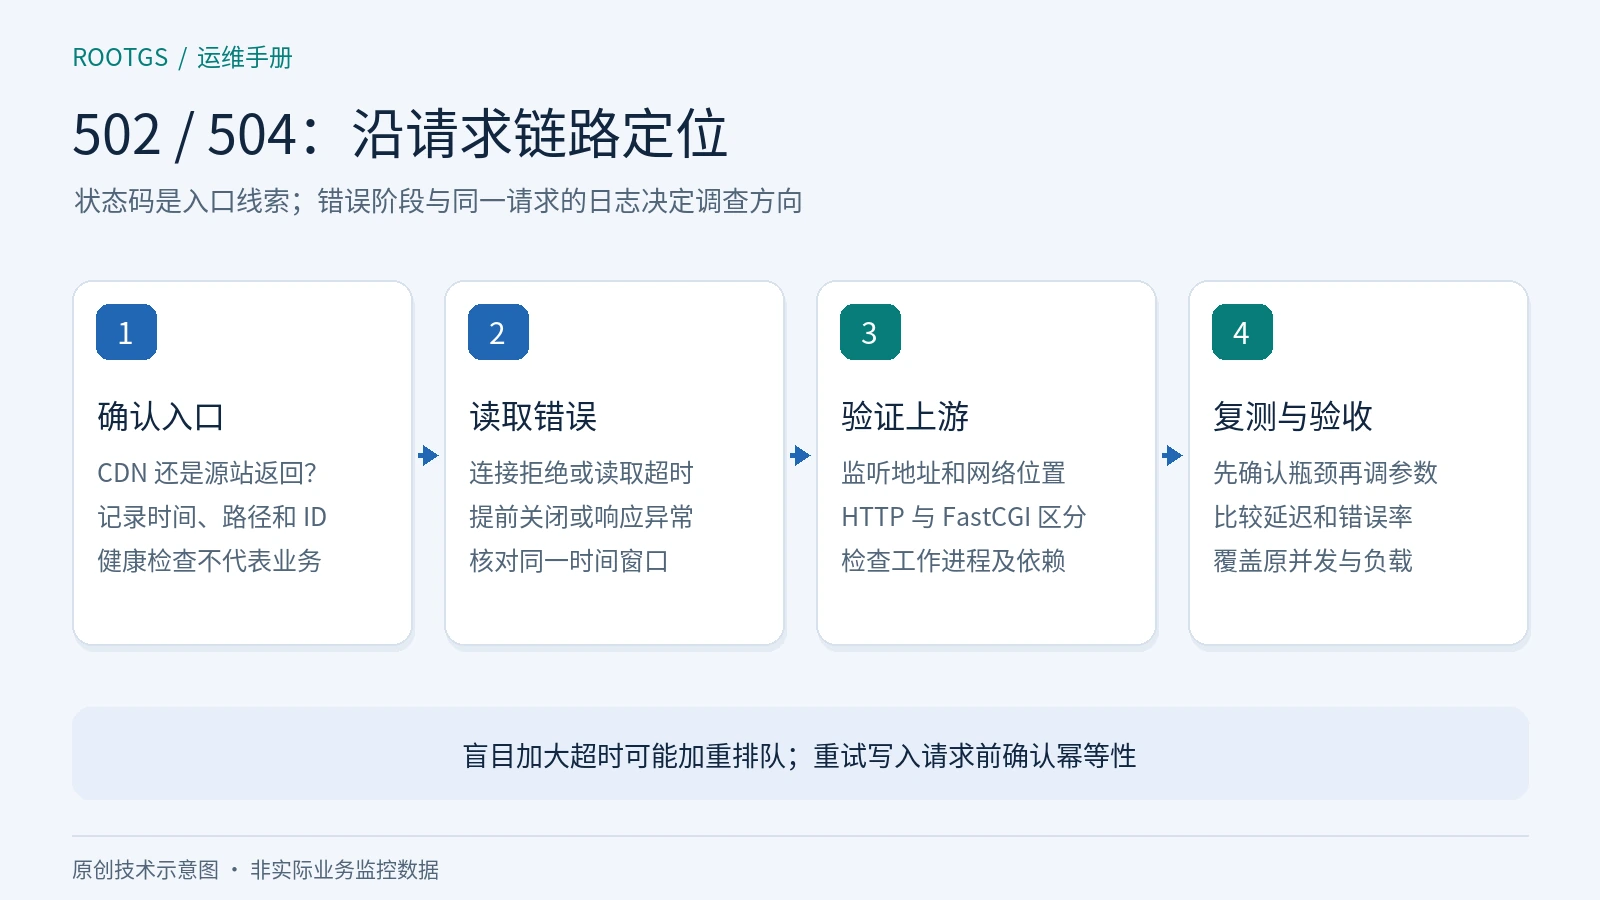
一、先画出实际请求经过的链路
常见链路是访客、CDN、Nginx、应用进程、数据库或外部接口。先确认是哪一层返回错误:访问日志是否有这次请求,应用是否收到请求,错误页和响应头来自哪里。单靠 Server 响应头不能保证定位准确,因为代理可能改写它。测试时记录时间、路径和已有的请求标识;涉及账号的查询参数应脱敏。
从两个角度复现:正常公网入口和受控的内部上游探测。二者必须尽量使用相同路径、方法和必要的主机名。一个返回 200 的健康检查,只能证明它自身成功,不能代替登录、查询或下单接口的验证。不要为复现问题随意重复真实付款或发货请求。
二、错误日志比单独的状态码更接近原因
| 日志线索 | 优先核对 | 不能直接推断 |
|---|---|---|
| connect() failed / Connection refused | 上游监听地址、端口和进程状态 | 不能证明整台服务器断网 |
| upstream timed out | 超时发生在连接、发送还是读取阶段 | 不能一律通过加大时间解决 |
| prematurely closed connection | 应用退出、崩溃、请求终止和自身超时 | 不能只责怪代理配置 |
| invalid header | 协议、响应格式和连接目标 | 不能假定端口可连就协议正确 |
不同版本的日志措辞可能不同,保留完整的错误阶段比摘取一个英文词更有价值。Unix socket 还要检查文件是否存在、路径是否匹配以及服务用户的目录访问权限。不要通过将 socket 或目录权限开放给所有人来掩盖配置问题。
三、验证上游是否真的可用
以下为 Linux 示例,路径和端口需要替换为实际环境。先读指定时间窗口的日志,再查看监听;不要把整份带请求参数的日志公开粘贴。curl 仅适合明确提供 HTTP 的上游,不能拿它直接请求 PHP-FPM 的 FastCGI 端口。
# 查看 TCP 监听与相关进程(权限不足时进程信息可能不可见)
ss -lntp
# HTTP 上游示例:仅限你确认无副作用的健康检查路径
curl --connect-timeout 3 --max-time 10 -I http://127.0.0.1:8080/health
某些应用不支持 HEAD 方法,此时 405 不等于服务不可用,应按应用文档选择无副作用的 GET 检查。虚拟主机还需要正确的 Host;HTTPS 上游另有证书验证和 SNI 要求。若应用运行在容器中,宿主机的 127.0.0.1 与容器内的 127.0.0.1 不是同一个网络位置,要在 Nginx 实际所在的网络环境验证连接。
四、区分连接时间、响应等待和应用耗时
Nginx 的 proxy_connect_timeout 控制建立上游连接的等待。proxy_read_timeout 针对连续两次读取之间的等待,不是整次请求的总时长上限。应用持续输出数据时,请求总时长可能超过该值。反过来,应用长时间完全不输出,就可能触发读取超时。FastCGI 使用自己的对应配置,修改 proxy 参数不会自动影响 PHP-FPM。
若日志已经包含 request_time、upstream_connect_time、upstream_header_time 和 upstream_response_time,可用它们辅助区分连接慢、首部慢和整体响应慢。字段的缺失值以及多个上游尝试需要按实际日志格式解释,不要简单将每一行当作只有一次后端请求。增加日志字段属于配置变更,应先检查语法再按服务流程加载。
五、把资源异常和应用依赖串起来
上游进程存在不代表还有空闲工作进程。检查应用队列、并发上限、数据库连接池、慢查询以及外部接口等待,并对齐到发生错误的分钟。内存不足导致进程被终止,也可能出现短暂 502;磁盘写满可能影响会话、缓存和数据库,使表现看起来像应用故障。先确认瓶颈,再考虑扩容或修改并发。
单纯把超时从几十秒增加到几分钟,可能让更多连接长时间占用资源,加重排队。对于本来就需要很久的导出任务,更合适的设计往往是提交任务后异步执行,再查询状态。对订单类请求重试之前应确认业务幂等性,避免错误页面背后其实已经成功写入数据。
六、用同一组请求完成修复验收
每次只修改能够解释现有证据的一项设置,保存旧值并执行配置语法检查。修复后比较错误率、延迟和上游资源使用,覆盖正常并发与故障时的负载。若只在低流量时成功,仍不足以证明峰值问题已解决。报告应写清哪层失败、证据是什么、改了什么,以及如何回退,而不是只记一句“重启后正常”。
