
“No space left on device” 不一定表示磁盘被一个大文件占满。容量、inode、配额或特定存储层的限制,都可能使写入失败。df 显示满而 du 找不到对应大小,也有合理解释。先确定失败发生在哪个文件系统,再决定清理对象,能减少误删业务数据的风险。
RootGS 技术编辑 · 2026 年 9 月 17 日 · 原创排障指南;命令中的目标和路径需按实际环境替换
一、从报错路径查起,不要只看根分区
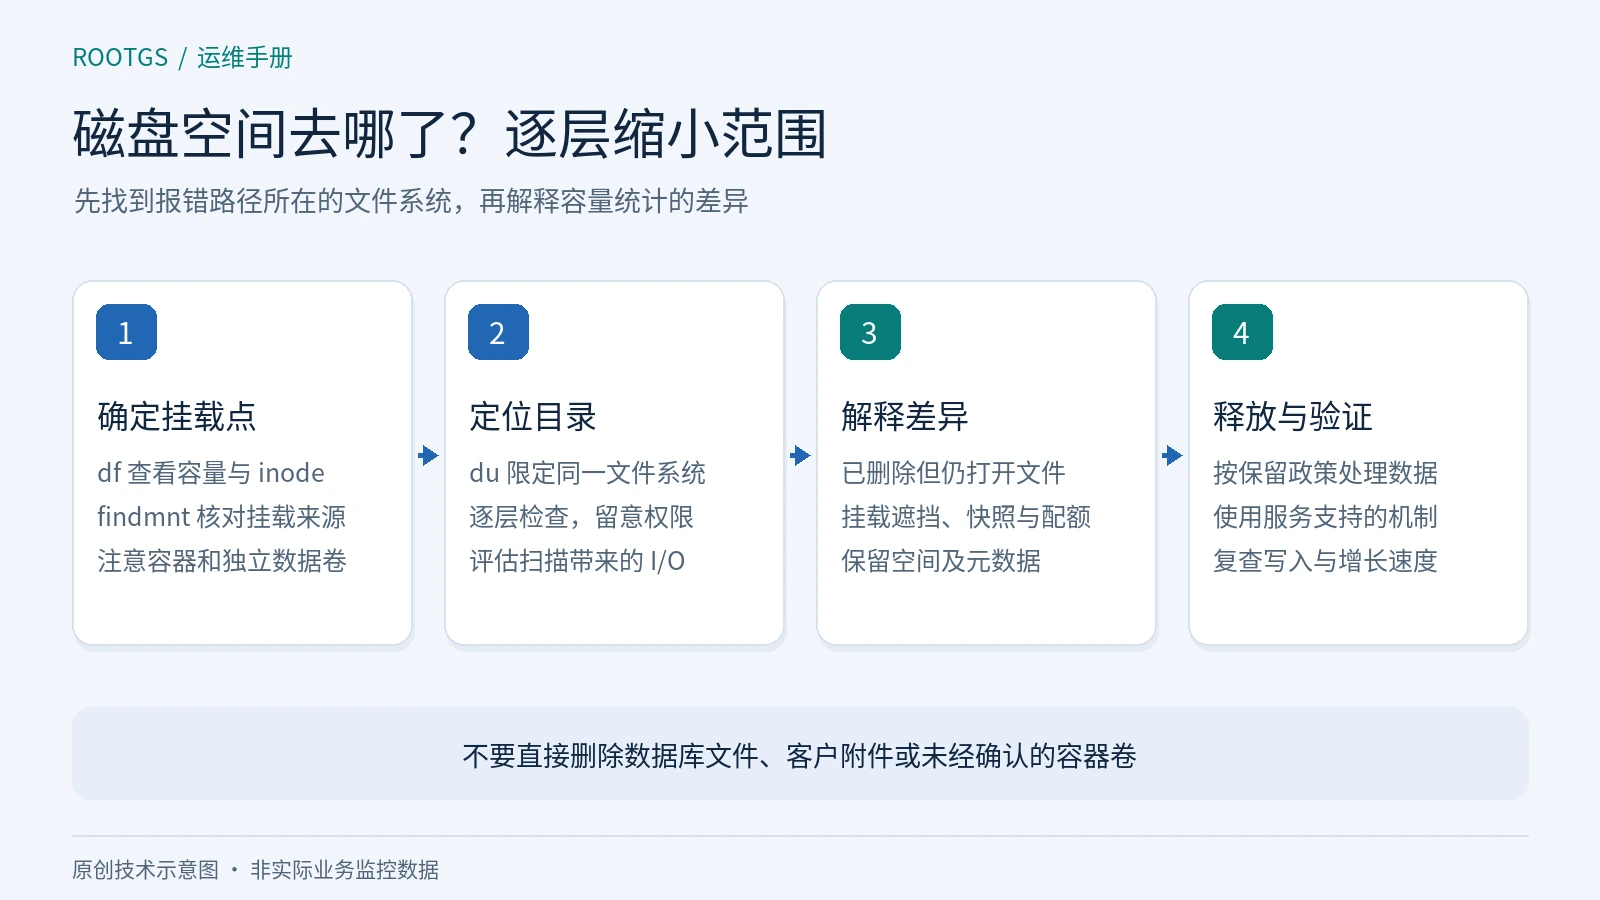
数据库、上传目录和临时文件可能分别位于不同挂载点。先取得实际写入失败的路径,对该路径运行 df;下面的 /var 是教学示例,请替换为真实目录。如果目录位于容器或网络存储中,需要同时考虑对应命名空间和后端容量,宿主机根分区有空间并不代表业务卷可写。
df -hT /var
df -i /var
findmnt -T /var
df -hT 查看文件系统类型和空间,df -i 查看 inode 使用情况,findmnt 帮助确认挂载来源。若字节空间仍有余量、inode 接近耗尽,应寻找大量小文件,例如会话、缓存和队列残留。不同文件系统管理 inode 的方式不同,不能照搬另一台机器的固定阈值。若两者都正常,再查配额、只读挂载及具体错误码。
二、逐层缩小目录范围
使用与 df 对应的挂载点进行目录统计。GNU du 的 -x 限制在同一文件系统,避免跨入另一个挂载卷后把数据混在一起。只看一层,再进入异常目录继续检查;对数百万文件的目录,遍历会产生额外 I/O,应在合适窗口执行,不要反复并发运行扫描。
# GNU/Linux 示例:按实际挂载点替换 /var
du -x -h --max-depth=1 /var
# 需要比较大小时,可对上述输出使用 sort -h
journalctl --disk-usage
使用有权限的账号,并留意 Permission denied 等提示;没有读权限的扫描结果不能当作完整总量。journalctl 的统计包含活动和归档日志,可帮助判断系统日志的占用,但并不覆盖应用自己写入的所有日志。du 与 df 的统计对象不同,不应期待任何时刻都精确相等。
三、检查“已删除但仍打开”的文件
在 Linux 中,删除文件名后,只要进程仍持有打开的文件,相关空间就可能继续占用。此时目录遍历看不到它,df 却仍显示占用。典型场景是人工删除正在写入的巨大日志,服务没有重新打开日志文件。若系统已安装 lsof,可用以下只读命令辅助定位:
lsof +L1重点看进程、文件描述符、大小和所在设备,确认它确实属于空间紧张的文件系统。没有权限或工具缺失时,空结果不能证明不存在这种情况。对确认的日志文件,优先使用该服务官方支持的日志重新打开机制;必要时安排受控重启。不要按 PID 批量杀进程,也不要直接截断 /proc 下的文件描述符,那里可能关联数据库或仍需保留的数据。
四、别忽略挂载遮挡、保留空间和快照
一个目录原先写入过数据,后来又挂载了其他文件系统,原来的文件会被遮挡;普通路径访问看到的是新挂载内容,旧数据仍可能占用原来的磁盘。不要为了查看它而直接卸载生产挂载点,应在维护窗口由了解挂载结构的人通过隔离方式检查。
部分文件系统有保留块、元数据及其他管理开销,普通用户可用空间与总空闲量可能不同。采用快照、写时复制或存储池时,删除当前可见文件也未必立刻释放底层空间。应查看对应文件系统和存储平台的工具,而不是因为 du 总量较小就认定统计错误。对稀疏文件,表观大小和实际占用也需要区分。
五、按数据价值安排释放空间的顺序
先确认哪些缓存可以重建、哪些归档已有独立备份、哪些日志有审计保留要求。处理必须使用应用或系统支持的保留机制。journalctl 的 vacuum 选项主要移除归档日志,活动文件仍可能占用空间,因此清理后的总量不一定降到设定值;清理前应确认保留期限和所需证据已经保存。
数据库文件、事务日志、容器卷和客户附件不能按照“大文件”直接删除。数据库应通过其自身的归档与清理机制处理;容器清理也需确认卷是否仍存放持久数据。若容量已严重不足而数据不能安全删除,扩容或迁移经确认的非关键文件通常比盲目清理更可控,但仍要核对挂载和文件系统扩展条件。
六、验收同时看空间和业务写入
处理后对同一挂载点重新检查字节空间和 inode,确认业务错误停止,并按应用流程进行小规模写入验证。随后观察增长速度:如果清出空间后很快再次耗尽,应找出异常增长的来源,而不是每天重复清理。为每个关键挂载点分别监控剩余容量、inode、增长趋势和写入错误。
一份合格的处理记录应说明报错路径、文件系统、主要占用来源、释放方式、是否影响服务以及恢复后的可用量。这样下一次告警出现时,团队能判断是正常增长、日志轮转失效还是业务异常,而不必再次从删除文件开始试错。
