
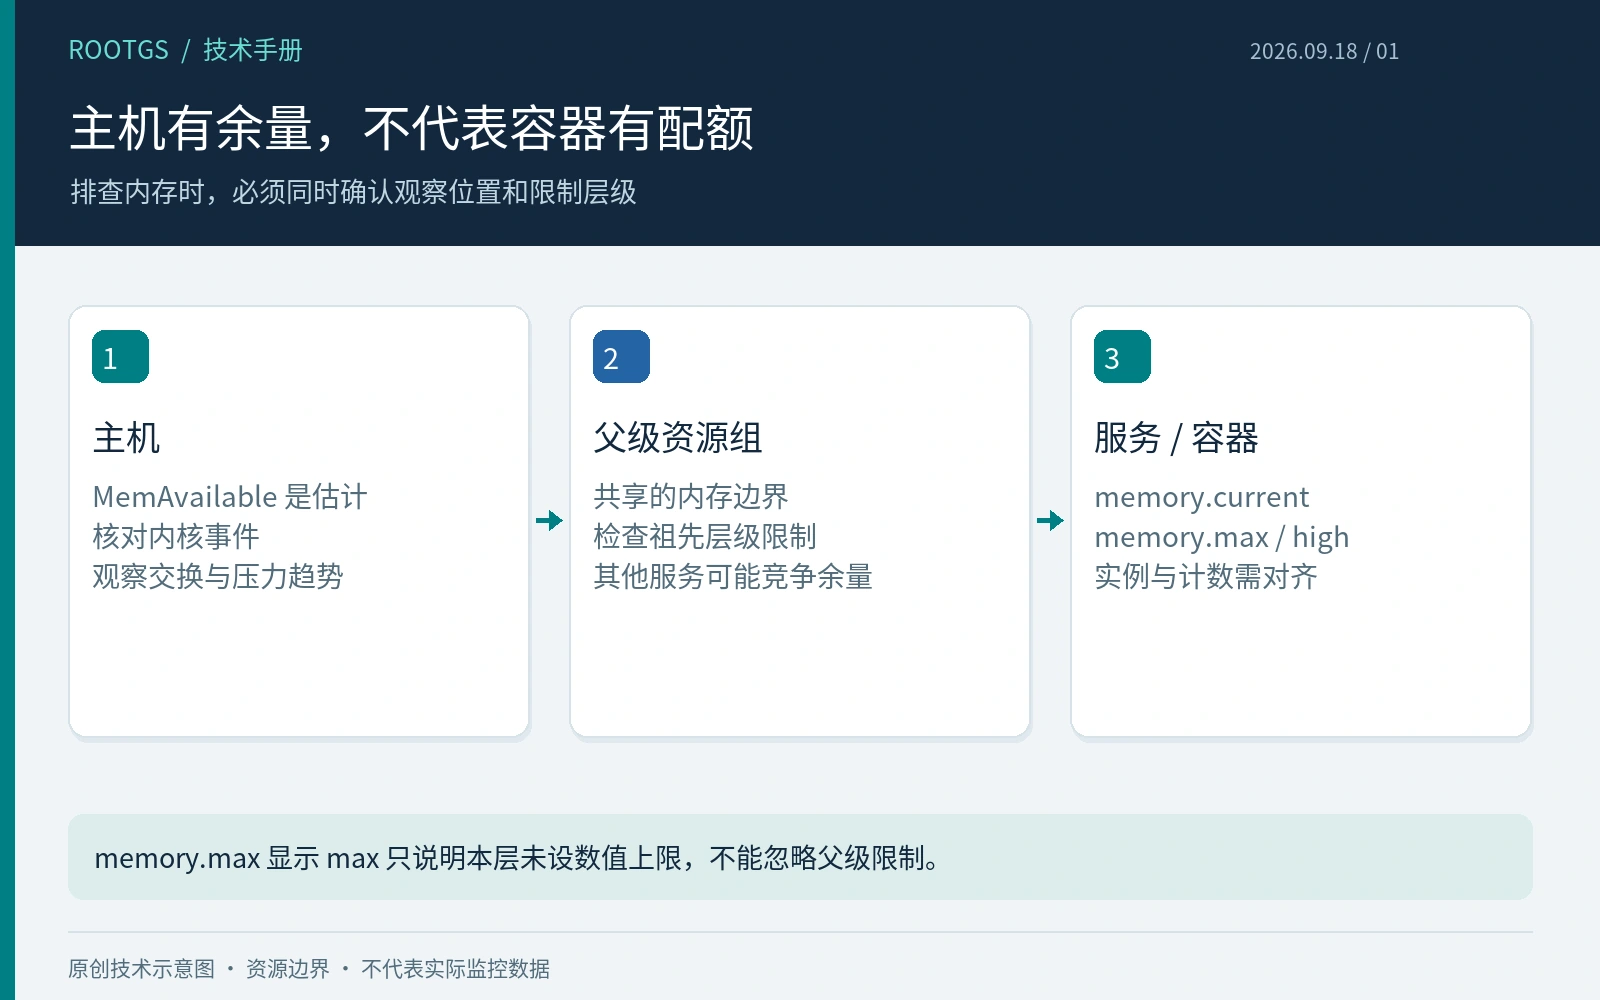
“free 还有可用内存”与“容器里的进程因内存限制被杀”可以同时发生。主机、容器和服务组可能拥有不同的资源边界;退出码也只能提供线索,不能独立证明内存不足。排查的第一步是确定谁终止了进程、当时哪个边界被触发,再讨论扩容、限流或修复内存增长。
RootGS 技术编辑 · 发布日期:2026 年 9 月 18 日 · 原创技术指南
一、区分三个容易混淆的问题
第一,Linux 会将部分内存用于缓存,所以 free 很低并不一定意味着系统已经没有可用余量。第二,主机的可用内存不能代表容器剩余配额。第三,进程退出可能来自内核 OOM、服务管理器、部署脚本或人工信号,不能把所有突然退出都归为 OOM。
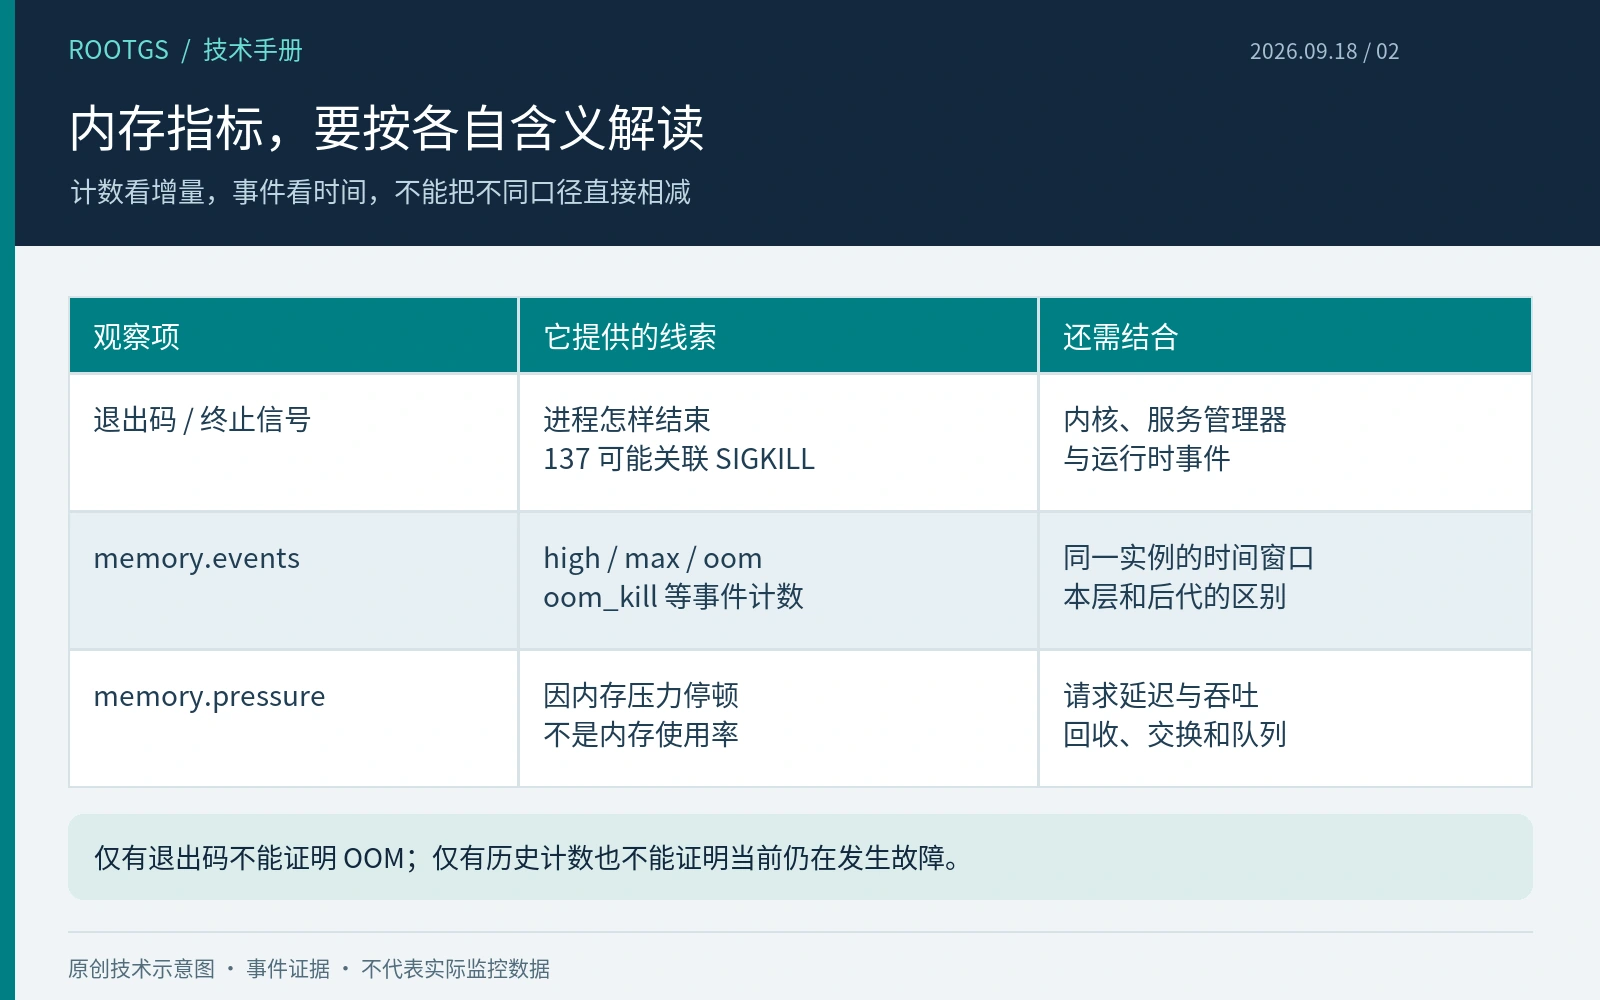
某些环境将 SIGKILL 表示为退出码 137,但同样的信号也可以来自人为操作或平台策略。应把退出时间与内核、服务和容器运行时的事件对齐。记录时区及实例标识,尤其要避免拿新启动容器的计数去解释旧实例发生的故障。
二、从主机视角建立时间线
下面的只读命令适用于具备对应工具的 Linux 主机。首先获取内存、交换区与内核事件;日志范围应缩小到事故前后,不要把包含内部地址和进程参数的完整日志公开。
date -Is
free -h
vmstat 1 5
journalctl -k --since '30 minutes ago' --no-pager
查看内核日志中是否有 out of memory、oom-kill 或被终止进程的记录,但不要只按关键词截掉上下文。没有权限、日志已轮转或故障发生在容器外层时,查不到记录不等于没有 OOM。还要核对服务管理器和容器平台记录的退出原因、重启次数与时间。
MemAvailable 是内核对“不发生交换时仍可用于新应用”的内存余量估计,并不是某个进程的保证配额。vmstat 的 si、so 可帮助观察换入换出活动;单个瞬间的数值不足以判断持续抖动,第一行与后续采样的统计口径也需要区分。把趋势和业务延迟放在同一时间轴上更有价值。
三、找到进程所属的资源边界
若机器采用 cgroup v2,应从宿主机或具备足够可见性的管理环境定位目标进程所属的 cgroup。下面的 1234 是示例 PID,目录也必须替换为实际路径;不要机械复制到另一台机器。容器命名空间可能让路径看起来不同,必要时通过运行时提供的实例信息定位宿主机目录。
cat /proc/1234/cgroup
# 替换为目标进程实际所属的 cgroup v2 目录
CG=/sys/fs/cgroup/your-service
cat "$CG/memory.current"
cat "$CG/memory.max"
cat "$CG/memory.high"
cat "$CG/memory.events"
cat "$CG/memory.stat"
memory.current 表示该组及其后代当前被计入的内存。memory.max 是硬边界,max 表示该层没有设置数值上限,但父级仍可能有限制。memory.high 是施加回收压力与节流的边界,不能简单等同于“到这里就杀进程”。排查时应沿父级检查限制,否则只看叶子容器可能漏掉更上层的共享配额。
memory.events 中的 high、max、oom、oom_kill 分别提供不同事件线索。记录事故前后的计数增量,结合该组的层级关系解释;累计值非零不意味着当前仍在发生故障。若需要区分本层与后代事件,可结合 memory.events.local。cgroup v1 的接口不同,不应照搬这些文件名。
四、区分内存增长、压力与真正的终止事件
一个进程的 RSS 上升,可能与并发、缓存、批处理输入或分配器行为有关,不能立刻认定泄漏。memory.stat 可帮助区分匿名内存、文件缓存及其他计费项;进程 RSS、容器计费和主机总量并非同一个口径,不应直接相减得出“丢失的内存”。
如果系统提供压力停顿信息,可检查 /proc/pressure/memory;对应 cgroup 也可能有 memory.pressure。PSI 描述任务因资源压力而停顿的时间情况,不是“内存使用百分比”。它适合与响应时间、吞吐和队列长度一起看,帮助识别应用尚未被终止但已经因回收或等待而变慢的阶段。
cat /proc/pressure/memory
# 仅在已定位的 cgroup v2 目录及接口存在时执行
cat "$CG/memory.pressure"
五、按证据选择处理方式
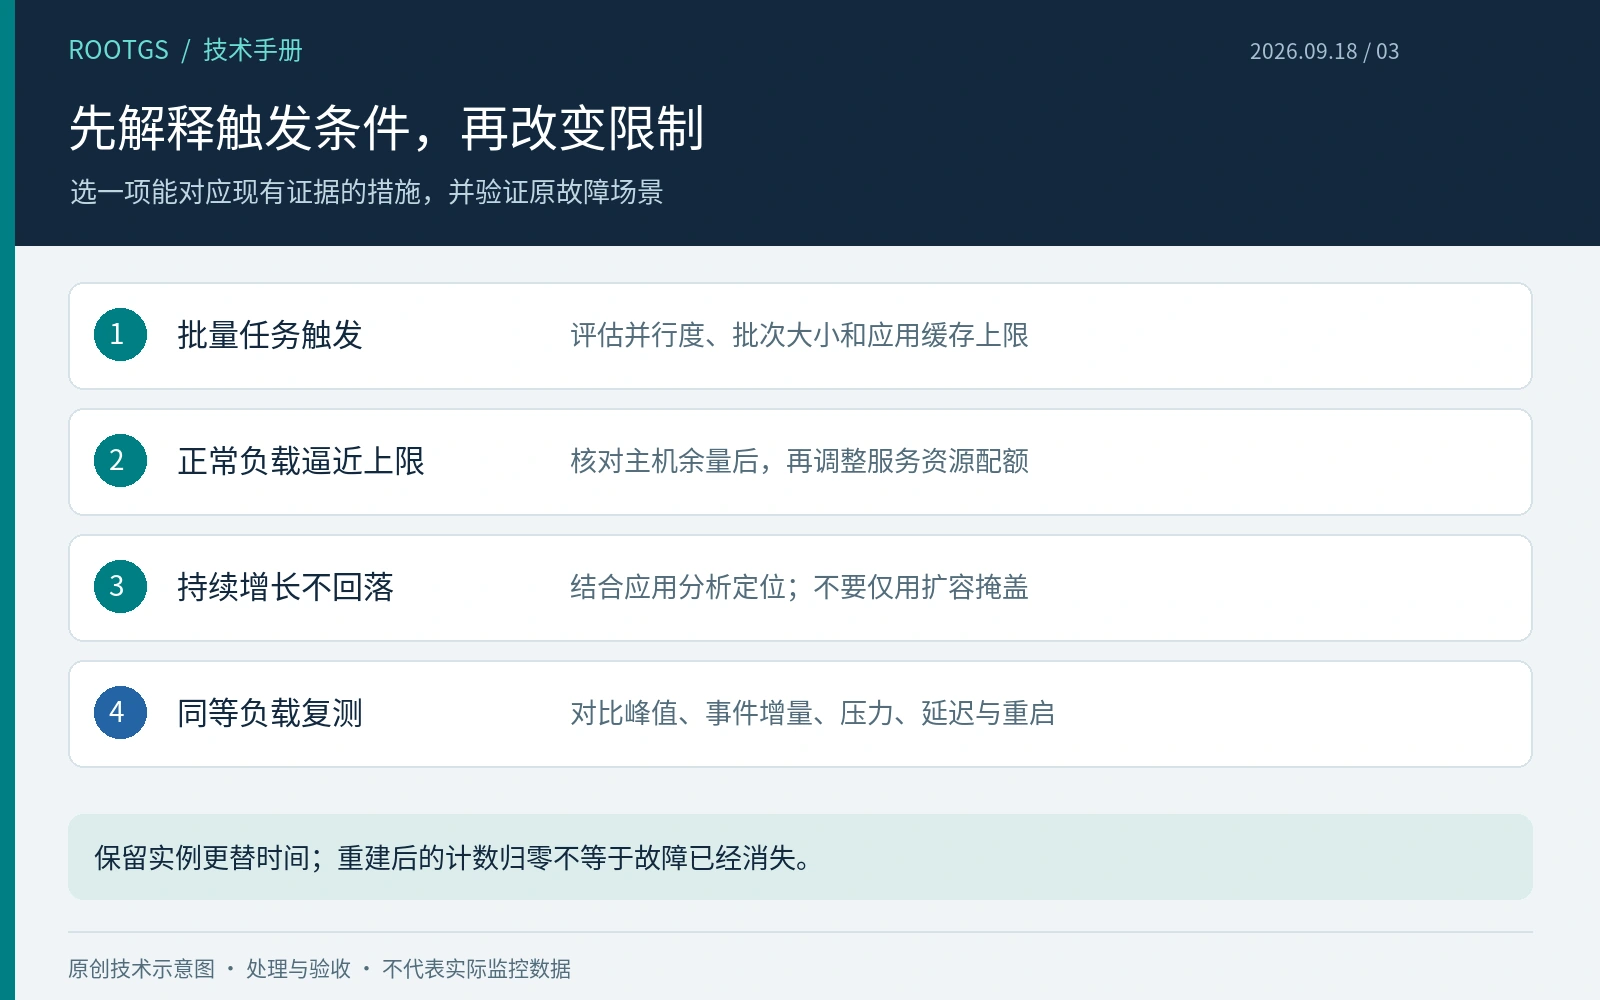
若只在批量导出或高并发时触发限制,先评估任务并行度、批次大小和应用自身的缓存上限。若正常业务就长期逼近配额,应在确认主机容量和相邻业务余量后调整资源。若内存持续增长且不会随负载下降,再结合应用分析工具检查对象生命周期,不要仅靠增加限制掩盖长期增长。
不要把禁用 OOM 保护、无限放宽所有容器限额或清空系统缓存作为通用修复。它们可能把单个服务的问题扩散成整机不可用。交换区也不是所有场景的固定答案:它可能提供缓冲,也可能让访问延迟显著增加,需要结合工作负载、存储与限制策略评估。
六、用同等负载验证,而不是只确认进程重新启动
验收应覆盖曾经触发异常的请求量和任务规模。对比同一实例的内存峰值、事件计数增量、PSI、延迟与重启次数;容器重建后计数可能重置,应保留实例更替时间。若应用只是启动成功,但在原负载下仍触发同一限制,修复尚未完成。
一份可复用的事故记录应写清:受影响服务、主机余量、cgroup 路径及父级限制、事件时间线、处理前后参数和回退条件。这样才能分辨下一次是业务增长、配置收紧、并发变化还是程序异常,也能让资源扩容建立在真实负载证据上。
