
发布日期:2026 年 9 月 19 日 · RootGS 技术编辑
容器镜像不大,数据库也没有明显增长,主机磁盘却持续被写满。常见原因之一是容器标准输出不断进入日志文件,而部署时没有设置轮转。解决问题不能停在“清掉一个大文件”:必须识别日志来源、确认现有容器的实际配置,再为排障需要和磁盘预算制定留存方案。本文讨论 Docker Engine 的日志管理,不把所有磁盘增长都归因于日志。
一、先确定增长的是哪一类数据
主机空间可能被镜像层、容器可写层、数据卷、应用文件日志或 Docker 日志驱动消耗。先观察挂载点的容量和 inode,再结合 Docker 的空间报告确定方向。下面均为观察命令;输出中的容器名称请替换为实际名称。
df -h
df -i
docker system df -v
docker info --format '{{.LoggingDriver}}'
docker inspect --format '{{json .HostConfig.LogConfig}}' CONTAINER_NAME
docker inspect --format '{{.LogPath}}' CONTAINER_NAME
docker system df 并不是所有宿主机文件占用的完整账本,不能仅凭它的总计排除日志。默认日志驱动也不等于每个容器正在使用的驱动:单个容器可以有自己的配置。LogPath 的意义与驱动有关,空路径不能直接推出“没有日志”。记录容器 ID,避免重建后把新旧实例的数据混在一起。
二、区分标准输出和应用内部文件
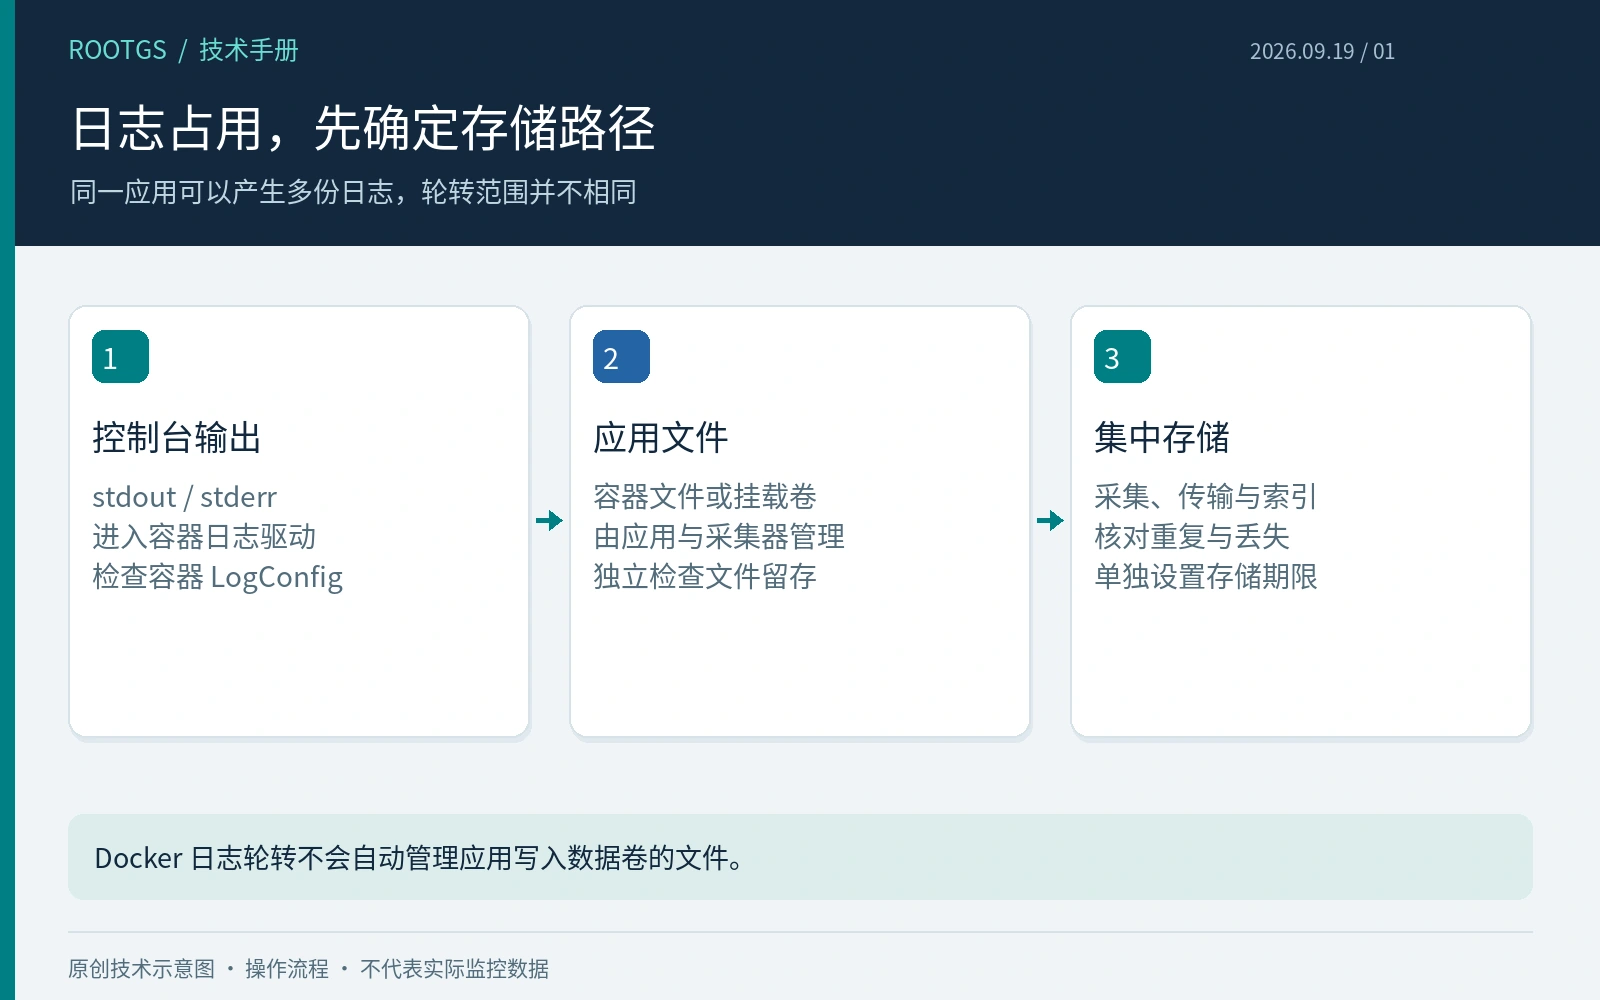
Docker 日志驱动主要处理容器的标准输出和标准错误。若应用还把日志写进 /var/log 下的文件或挂载的数据卷,给 Docker 设置轮转并不会自动管理这些文件。反过来,应用自身的文件轮转也未必限制标准输出对应的日志。
应用同时输出同一条事件到文件和控制台时,可能造成重复留存。先画清楚一条日志从哪里产生、谁收集、存到哪里、保存多久,再决定保留哪些副本。对于订单和审计事件,还要确认日志是否已经可靠进入独立存储,不能仅依赖一台容器主机。
三、为容器设置明确的轮转上限
json-file 驱动可以通过 max-size 和 max-file 限制轮转。下面是 Compose 的片段示例,应合并到已有服务下,不能直接替换完整部署文件。数值需要按业务日志速率和可接受的回溯窗口调整。
services:
  web:
    logging:
      driver: json-file
      options:
        max-size: "20m"
        max-file: "5"
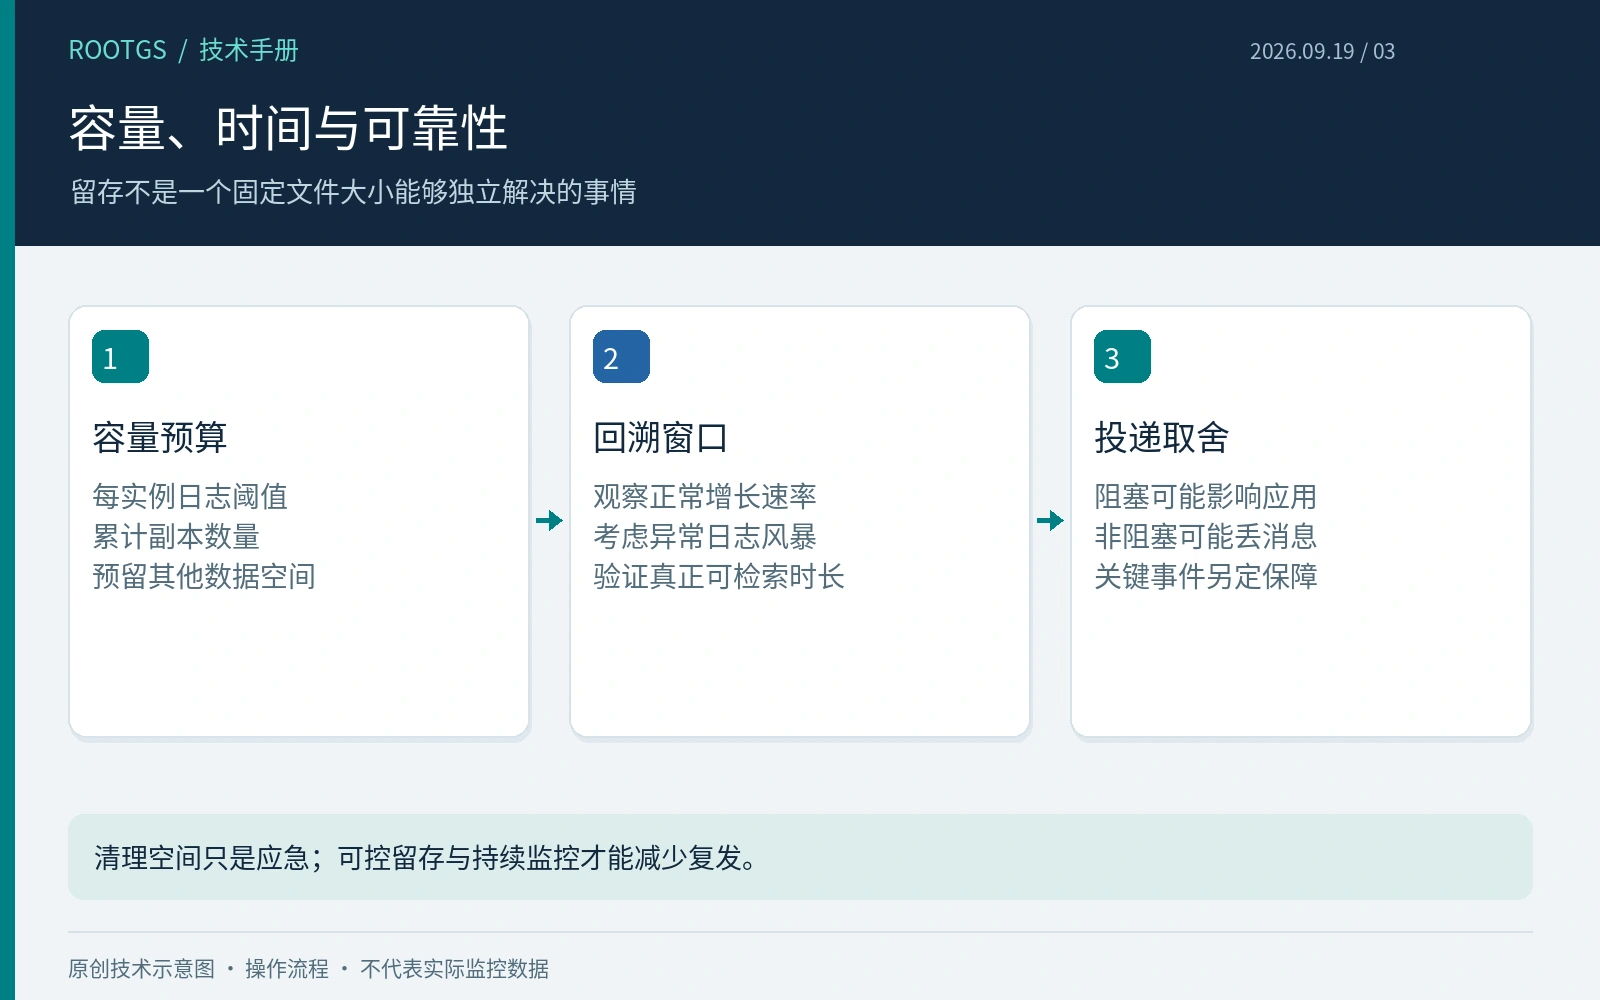
这表示配置单文件大小阈值与保留文件数量,并不是给整个主机设置总配额。多个副本各自保留日志,容量需要按容器数量累计,还应为元数据、短时增长、应用文件及其他数据预留空间。不要把阈值乘积当作绝不会突破的磁盘硬上限。
Docker 官方也提供具有轮转能力的 local 驱动。是否使用它,需要结合现有采集器和运维工具确认;依赖 json-file 文件格式的采集方式不能在切换驱动后默认继续工作。选定方案后应同时验证容器日志查看和集中采集。
四、配置写进去,不代表运行中的容器已经生效
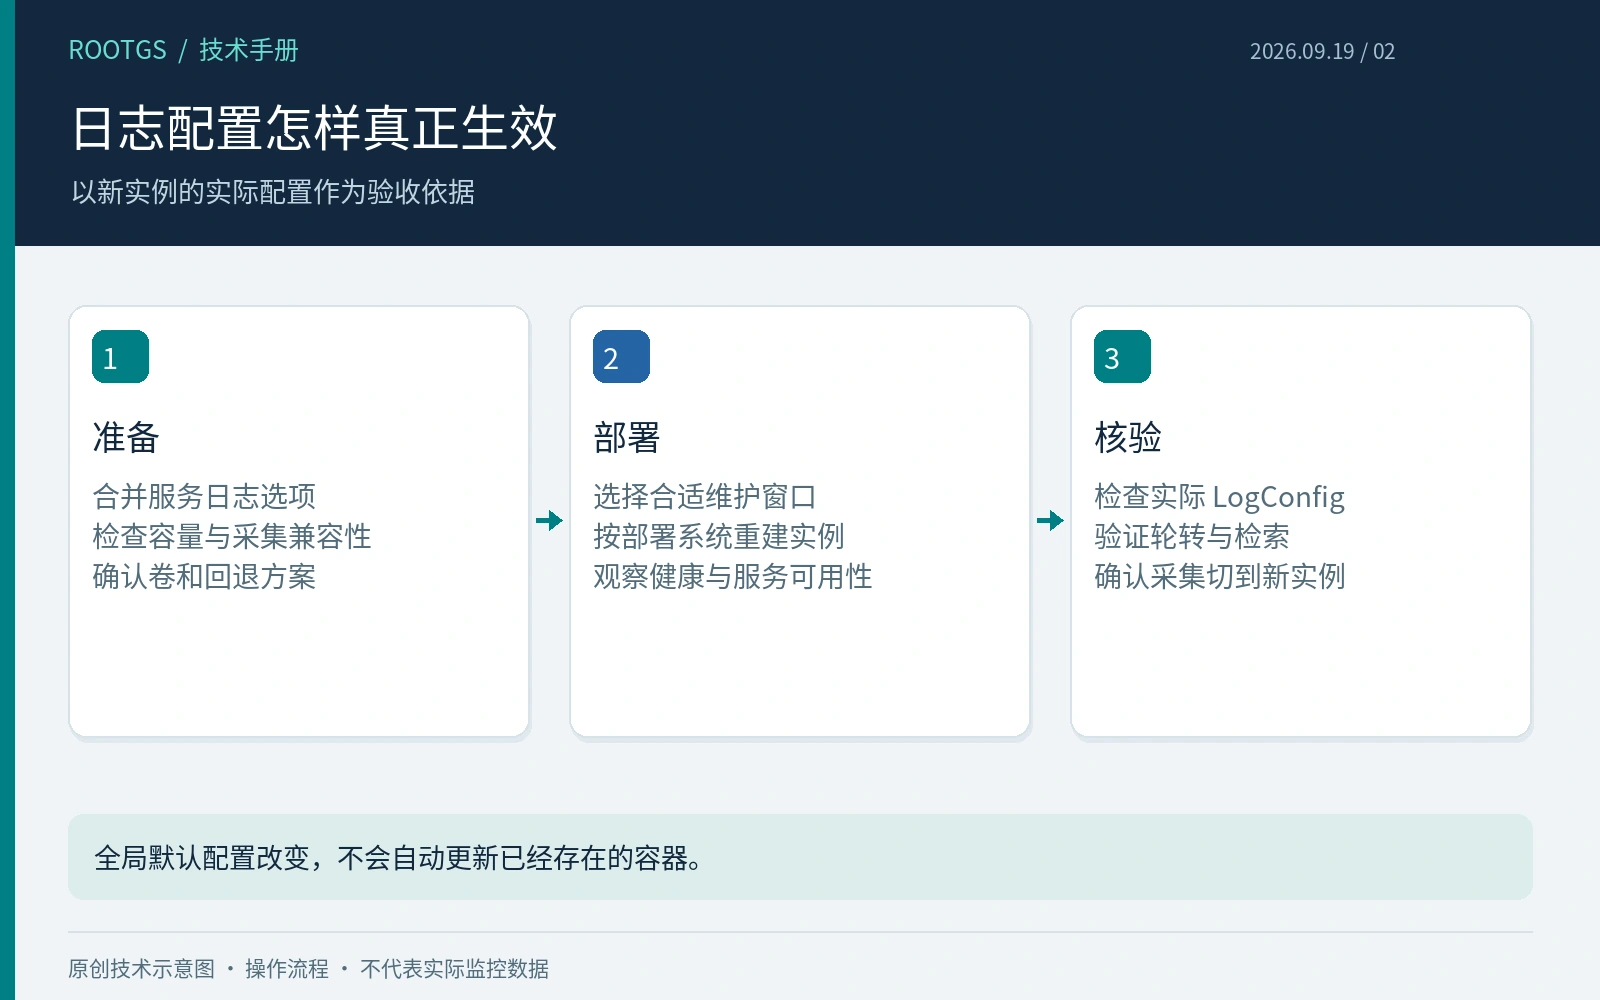
修改 Docker 守护进程的默认日志设置,不会自动改造已有容器。已有容器的日志选项属于创建时配置,通常需要通过部署系统重新创建容器才能采用新方案,仅重启原容器不能替代这一步。修改全局配置还涉及守护进程配置加载,应按当前运行环境安排维护。
先用 Compose 的配置检查确认 YAML 合并结果,再对可回退的单个服务实施变更。重建可能带来短时不可用,也可能暴露未持久化数据的问题,因此必须先检查卷、健康检查、依赖关系和发布方式。本文不提供一条对所有生产服务强制重建的命令。
五、磁盘告急时,不要直接删除 Docker 管理的日志文件
Docker 文档明确指出 json-file 日志应由守护进程管理,外部工具直接操作可能干扰日志系统。直接删除文件还可能遇到进程仍持有文件描述符、空间未立即释放的问题。不要把手工删除、截断或对活动日志额外套用不协调的轮转器当作长期方案。
更合理的应急顺序是:定位增长最快的实例,保留必要故障证据,降低异常日志产生速率,再通过受控重建或资源扩容争取空间。停止服务和删除容器都可能影响业务,执行前需要明确数据持久化、日志保留和恢复路径。也不要把清理所有未使用卷的命令当成通用磁盘急救,它可能删除仍有价值的数据。
六、留存时间要由日志速率推算
相同的容量预算,在低流量时可能保存数天,在异常重试风暴中却可能只保存很短时间。可以取有代表性的时间窗口测量增长速率,再估算能回溯多久,同时测试高峰和故障场景。若需要长期检索,应把集中存储的留存策略与本地缓冲预算分别管理。
日志输送方式也有取舍。阻塞式输送可能把日志后端的压力传递给应用;非阻塞方式使用有限缓冲,缓冲满时可能丢弃消息。不要为了减少延迟就认定非阻塞模式适合所有审计场景。关键业务事件应有适合其可靠性要求的记录机制,不能把普通控制台输出视为交易凭据。
七、变更完成后的验收清单
检查新容器的 LogConfig,确认驱动和参数确实符合预期;用受控测试日志观察轮转,而不是向生产持续灌入大量无用内容。随后确认 docker logs 或实际日志平台能找到预期事件,时间戳、时区和容器标识正确,采集器在重建后没有继续追踪旧实例。
最后对磁盘可用空间、inode、增长速率与采集失败建立监控,并记录告警后的处理人和动作。真正有效的治理结果是:空间使用可解释、日志可回溯、故障时有证据、部署后配置可验证。磁盘暂时空出来,只说明完成了应急处理,还不能证明问题不会复发。
