
发布日期:2026 年 9 月 21 日 · RootGS 技术编辑
把文档上传到知识库,模型能够输出完整句子,并不代表问答系统已经可用。实际业务常见的问题是:答案引用旧政策、找不到表格中的限制条件,或者把其他部门的资料展示给当前用户。遇到这些现象,先更换更大的模型未必有效。本文沿着文档进入系统、被检索、再生成答案的路径,说明怎样区分质量问题与访问控制问题,并建立可以复测的验收方法。
一、先把一条回答拆成可观察的步骤
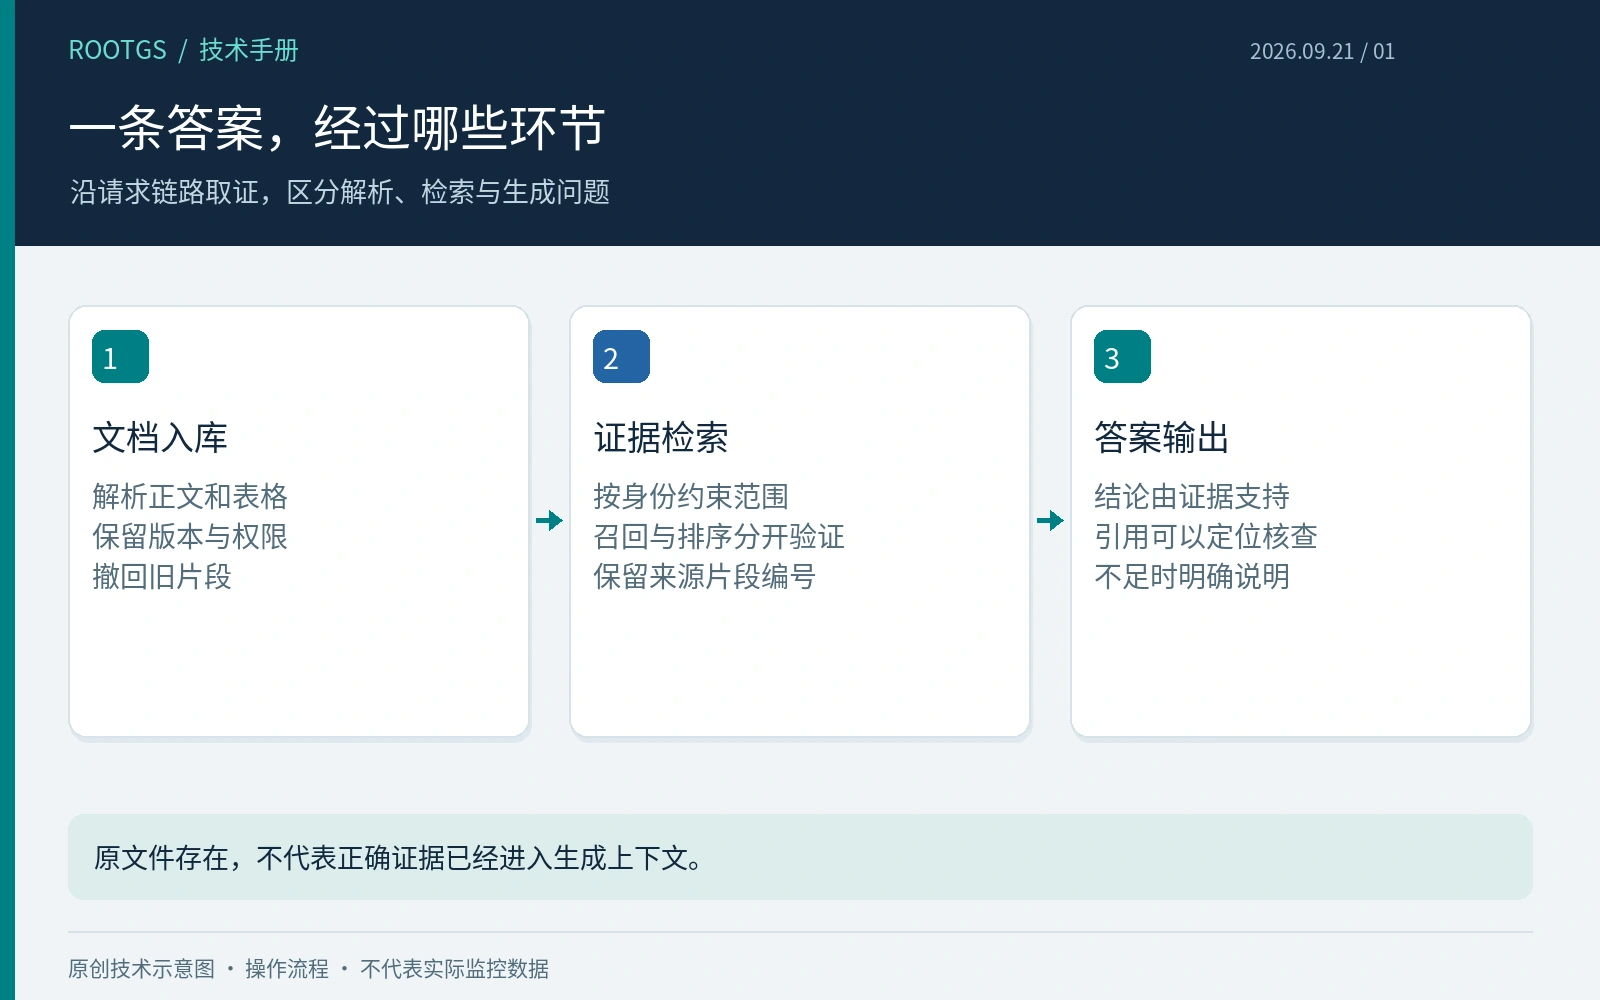
典型的检索增强生成流程包含文档解析、分块与索引、查询检索、候选排序、上下文组装和模型回答。每一步都可能丢失必要信息。文档库里存在一份文件,不等于目标段落已经被正确解析;检索命中相关标题,也不等于拿到了完整的适用条件。
为一次请求保留必要的追踪信息:问题标识、索引版本、检索到的片段编号、来源文档版本,以及最终使用的模型和提示模板版本。记录应满足访问权限与保留策略,不能把敏感全文无限复制到调试日志。用户反馈错误时,先回看这一条链路,才能知道该修哪一层。
二、文档清洗要保留业务含义
PDF中的双栏布局、表格、图片文字和页眉页脚,容易在解析后混成不连续的文本。价格表只留下数字、丢掉币种与适用日期,检索越准确反而越容易稳定地产生误导。抽样时应同时对照原文与解析结果,特别检查表格行列关系、单位、例外条款和跨页段落。
建立最小的文档元数据:来源、版本、生效时间、所属业务范围与权限标签。新旧政策不能仅靠文件名中的“最终版”区分。文档撤回、权限收回或替换后,还要检查索引中的旧片段是否及时删除或失效,否则原文件已经消失,问答仍可能继续引用旧内容。
三、分块和检索不能只调一个长度参数
把整本手册作为一个块,容易稀释主题并增加上下文负担;把每句话切成单独块,又可能把结论和前提拆开。更合理的起点是尊重标题层级、条款和表格边界,再用代表性问题测试。相邻块可以适当重叠,但重复内容会占用检索名额,不能依靠无限重叠弥补解析质量。
面对产品编号、错误代码、精确名称和自然语言描述,可以比较关键词与向量检索各自的召回情况,再评估混合检索或重排。先问“正确证据有没有进入候选集”,再问“它是否排得足够靠前”。如果证据根本没有被检索到,改写回答提示词通常无法凭空补回真实依据。
四、权限必须在可信服务端落实
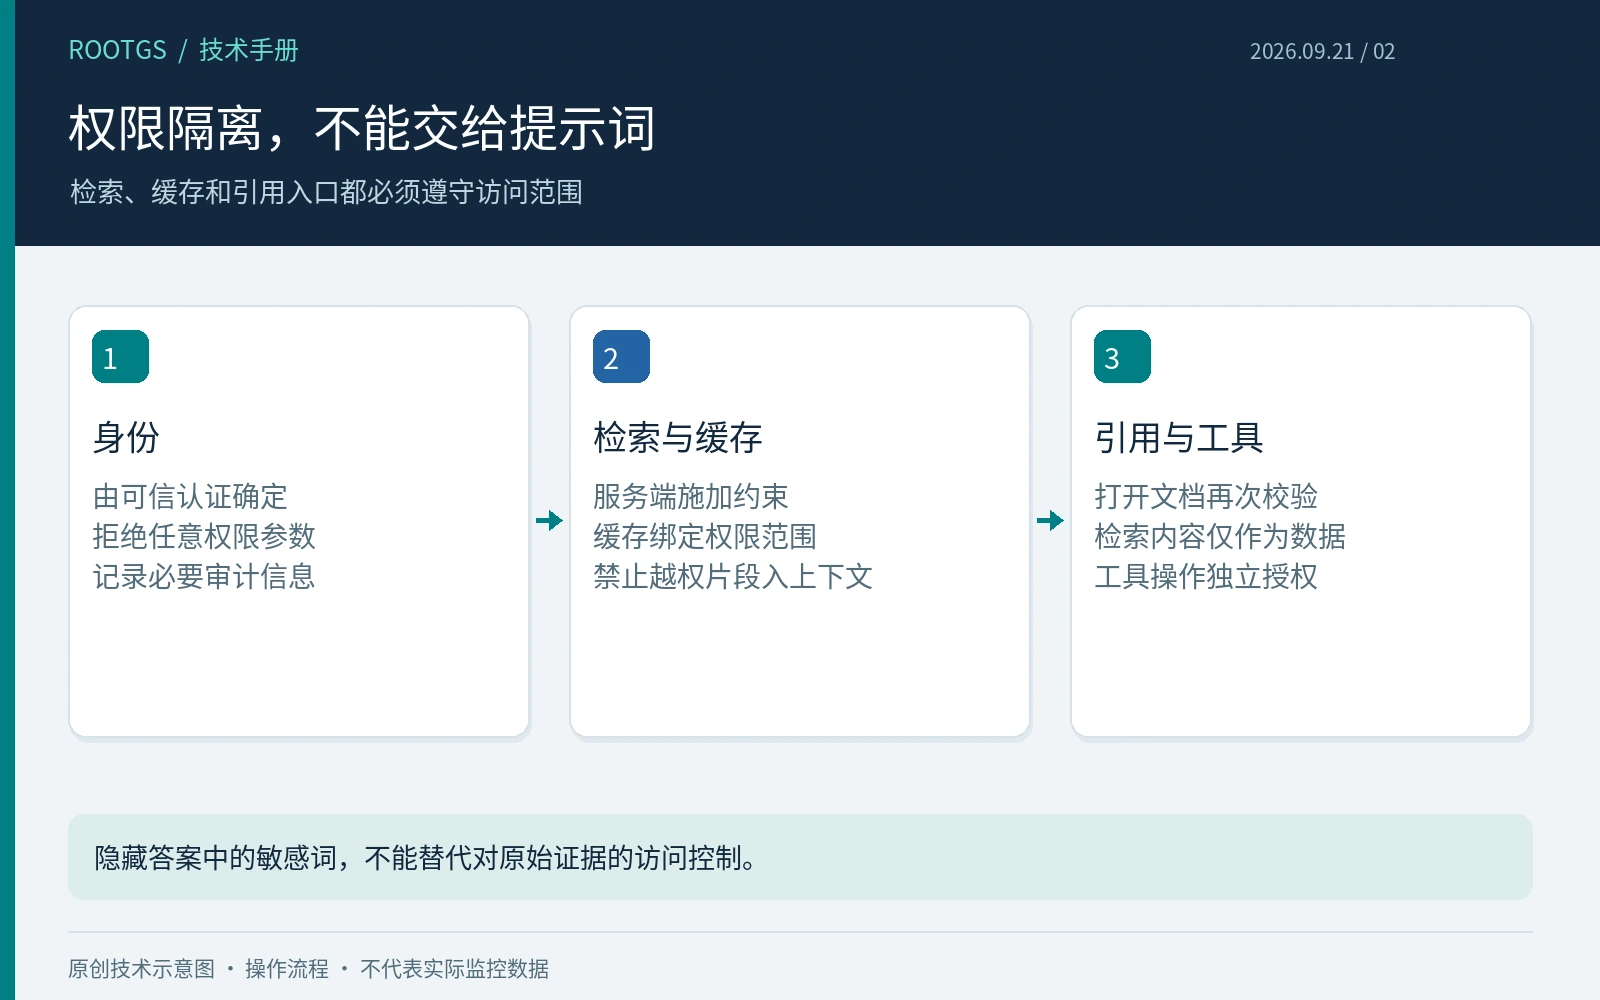
知识库中有客户专属价格或部门内部资料时,用户身份应由可信认证流程确定,再由服务端把权限约束加入检索。不能信任浏览器提交的任意部门编号,也不能先把全库结果交给模型,再要求模型“不要泄露”。没有权限的片段不应进入该用户的生成上下文。
检索结果缓存也要考虑身份与权限范围。若所有用户共用仅由问题文本生成的缓存键,相同问题可能命中另一个权限范围的答案。引用链接打开时同样要再次校验访问权限。文档里的“忽略前面要求”等内容属于被检索的数据,不应自动变成可执行指令或获得工具操作权限。
五、回答需要证据,也需要知道何时停止
为回答附上可定位的来源段落和版本,有助于用户判断结论。但显示引用并不证明答案受引用支持:模型可能引用了相关主题,却把数值、条件或时间范围写错。验收时应逐条核对关键主张能否从对应证据直接得出,而不只看有没有参考链接。
当证据不足、来源冲突或问题超出知识范围时,应明确说明缺少什么信息,必要时转交人工。可以把输出约束为简短结论、依据和待确认项,减少无依据扩写。对于费用、合同条件等需要精确结果的业务,更应采用明确的数据查询和校验流程,不能把语言生成当成事实数据库。
六、建立一套小而可复现的测试集
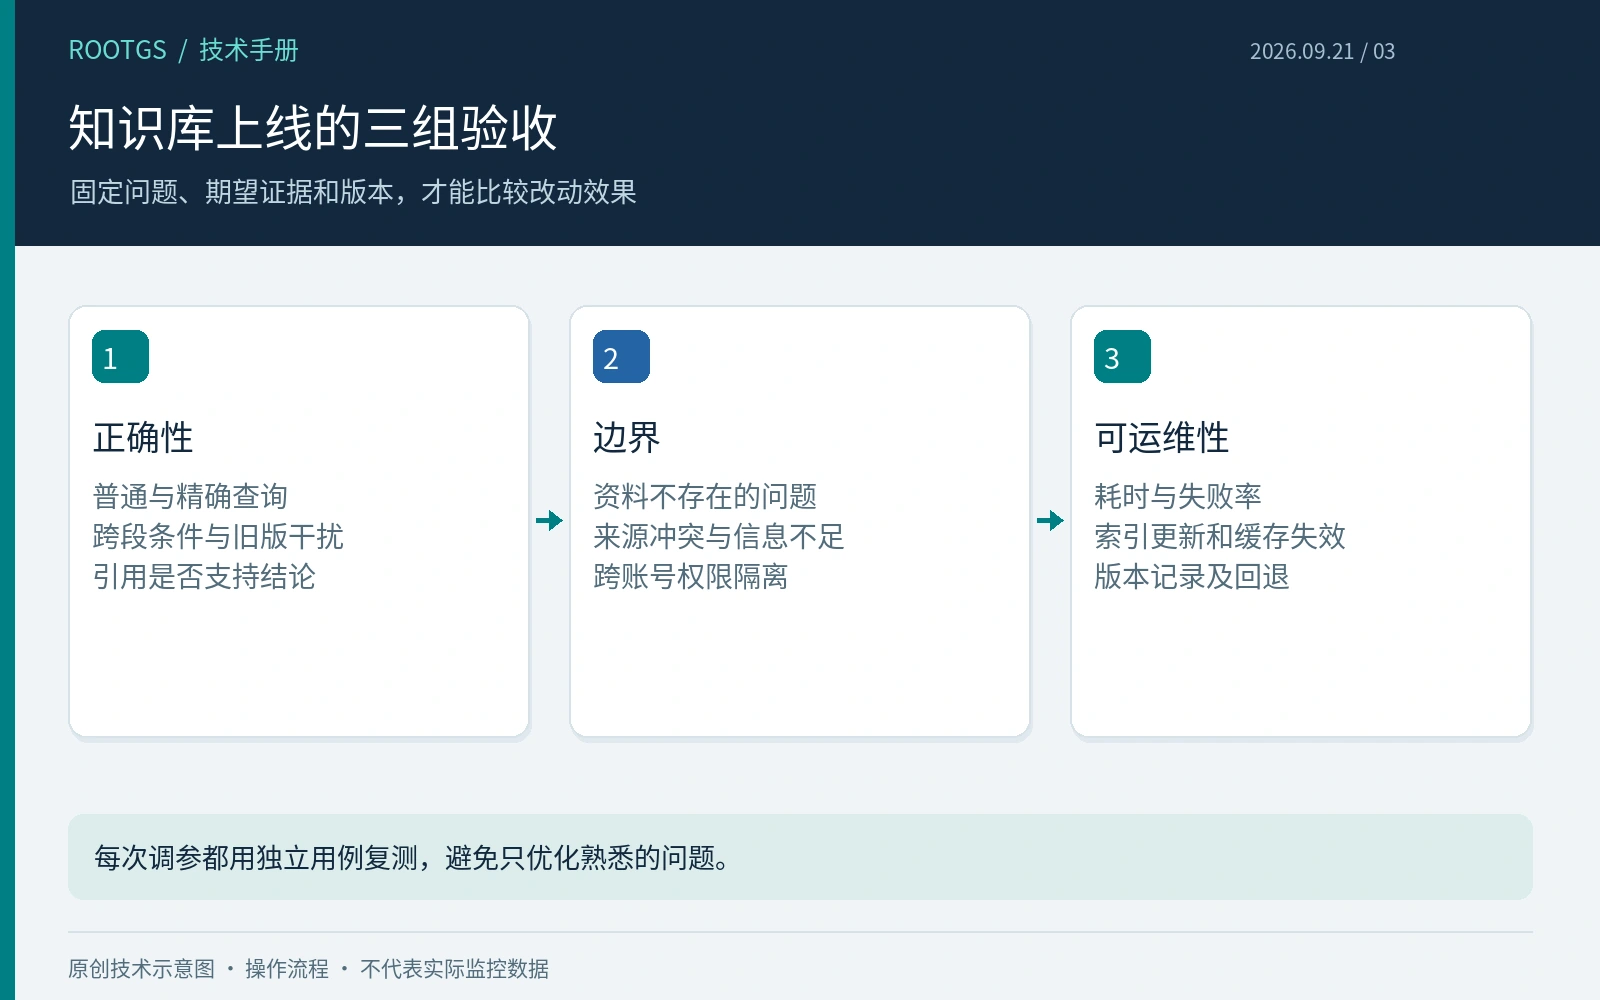
测试集应覆盖普通问题、精确编号、跨段条件、旧版本干扰、无答案问题和权限隔离。由了解业务的人提供期望证据及可接受答案,而不是只让同一个模型自问自评。对权限用例,还要使用有权与无权的不同账号分别测试,确认检索、缓存和引用入口都没有旁路。
分别记录证据召回、答案事实准确性、引用支持程度、无答案时的处理,以及响应耗时和失败率。保留一部分未用于调参的问题,防止系统只是记住样例。每次改分块、嵌入模型、索引或提示模板,都用相同条件复测,再比较改进是否牺牲了其他问题类型。
七、上线后把内容更新当作一次发布
索引更新也需要版本、验证和回退。可先在独立版本中完成导入与抽查,验证通过后再切换查询入口;回退时同时考虑索引、提示模板与引用文档是否仍匹配。不要只记录模型版本,却无法回答一次政策更新究竟在什么时候进入了检索结果。
运行监控应结合问题类型观察检索为空、无依据回答、响应变慢及权限拒绝等变化。先从范围明确的业务上线,再逐步扩展知识面,通常比一次性导入所有资料更容易建立可靠性。知识库问答的目标不是每个问题都说一段话,而是让可回答的问题有证据、不可回答的问题有清楚边界。
