
发布日期:2026 年 9 月 21 日 · RootGS 技术编辑
服务启动后几秒就退出,systemctl反复显示正在重启;过一会儿又出现启动过于频繁的提示。这时不断执行restart或reset-failed,通常只能暂时改变表象。应用为何退出、systemd为什么再启动,以及为什么停止重试,是三个不同问题。本文给出一种先保存证据、再修正服务运行条件、最后验证恢复的处理顺序。
一、先保留失败现场和时间线
记录服务名称、首次异常时间、最近发布或配置变更,以及当前是否影响用户。先看状态、退出信息与限定时间的日志,再决定是否需要操作服务。下面用example.service作占位,查询前应替换成实际单元;命令只读取信息,不会重启服务。
systemctl status example.service --no-pager -l
systemctl show example.service -p Result -p ExecMainCode -p ExecMainStatus -p NRestarts
journalctl -u example.service --since "30 minutes ago" --no-pager
日志可能包含连接地址和应用输出,向他人分享前应清理认证值与客户信息。若日志量很大,可先缩小时间窗口。系统重启、日志轮转和单元重新加载会影响可见记录,累计重启次数也应结合当前实例与时间解读。
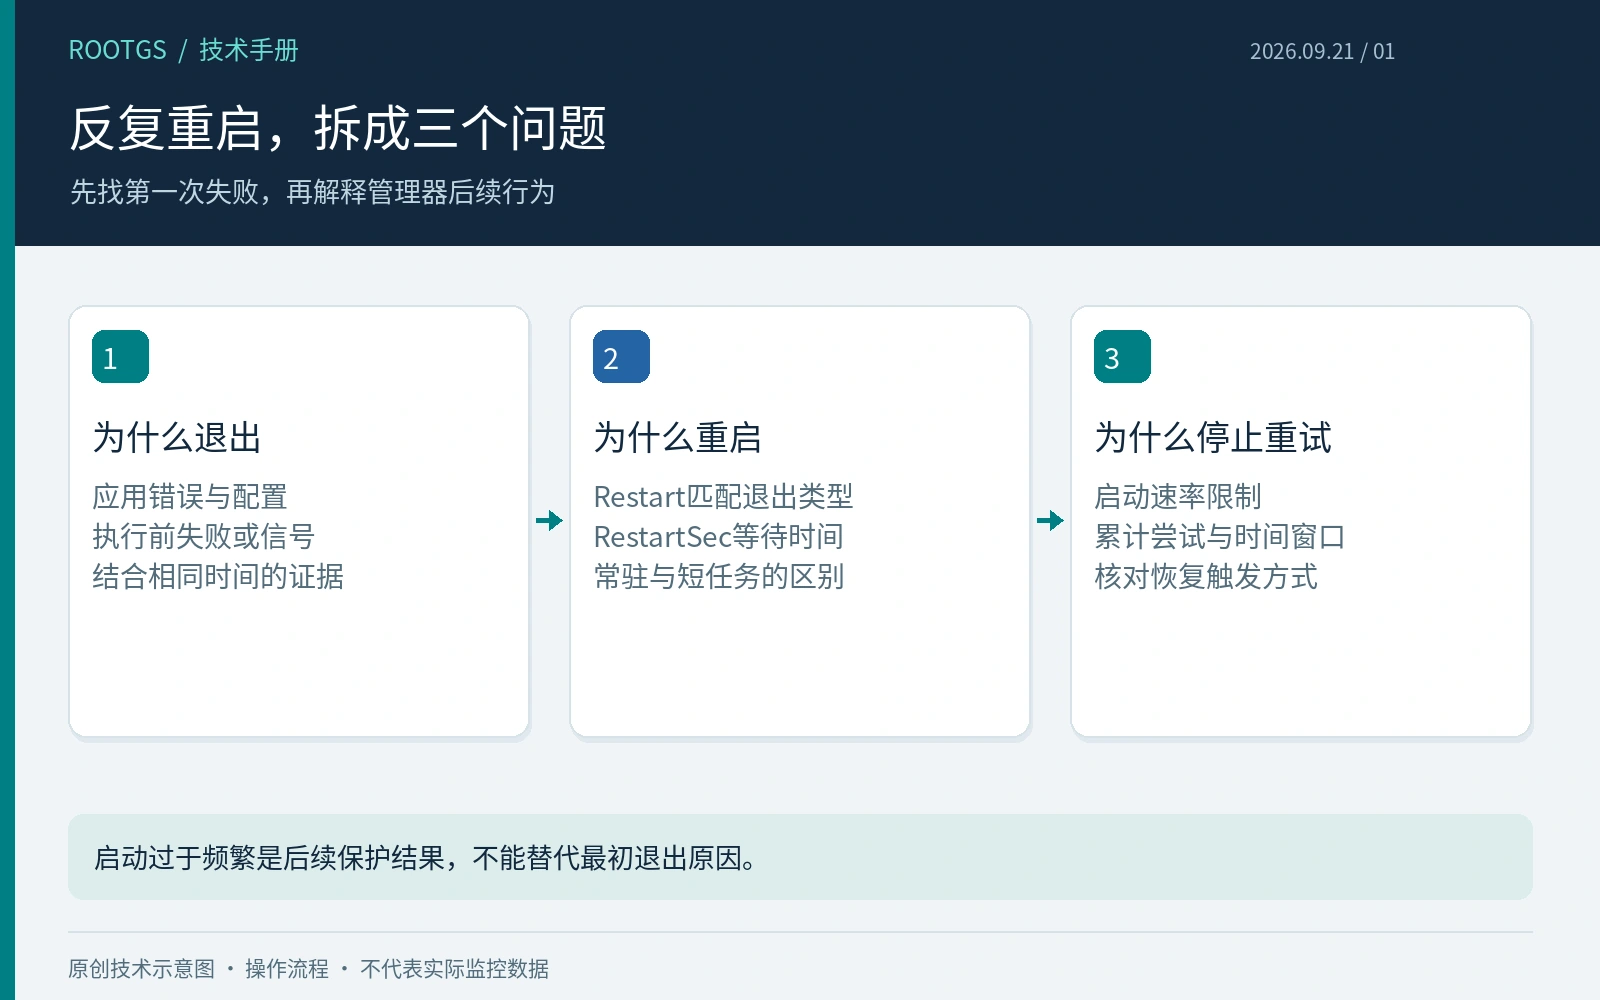
二、区分应用自己退出与外部终止
退出码提示进程如何结束,但必须结合应用日志才能解释原因。配置文件缺失、依赖连接失败、端口占用和权限错误都可能导致快速退出;收到信号也可能来自管理员、服务管理器或资源压力。仅看到非零退出码,不能直接认定程序代码有缺陷。
某些启动失败发生在主程序真正运行之前,例如无法执行目标文件、无法切换工作目录或无法使用指定账号。此时应检查systemd的具体错误和有效单元配置,不能只翻应用自己的日志。若涉及内存压力,再去对齐内核和资源组事件,避免把所有终止归为OOM。
三、终端里能运行,不代表服务环境相同
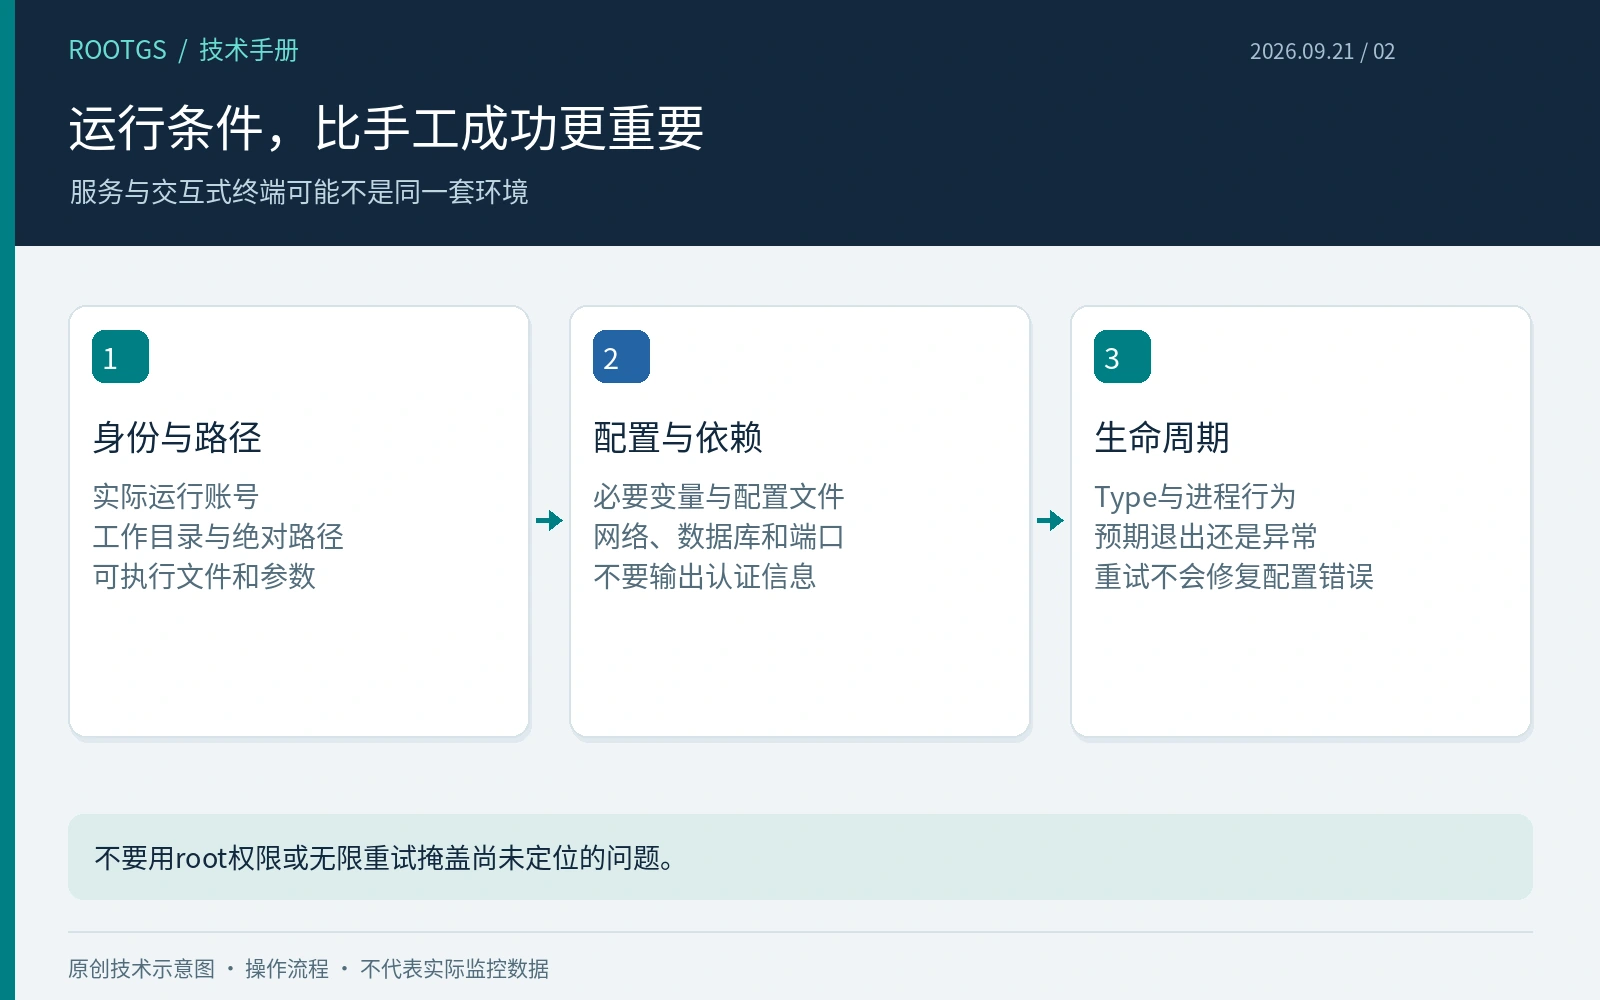
交互式终端与systemd服务可能使用不同的用户、工作目录、PATH和环境变量,也可能受到沙箱与文件访问限制。相对路径在终端可用,在服务里却可能指向其他位置。依赖shell初始化文件提供变量的程序,也可能在服务启动时失去必要设置。
检查ExecStart指向的可执行文件与参数、User和WorkingDirectory,以及必要配置是否通过既定机制传入。不要为了排错把完整环境变量打印到公开日志,也不要复制生产凭据到临时脚本。优先修正明确的路径和权限问题,而不是把服务改成root运行来绕过所有限制。
四、Restart策略决定重试方式,不负责修复应用
Restart根据退出类型和配置决定是否重新启动,RestartSec设置相应重试之间的等待。对于临时依赖故障,合理重试可能有帮助;对于错误配置或缺失文件,快速重试只是重复失败,还会放大日志与依赖请求压力。
长期运行程序与一次性任务的预期生命周期不同。应先确定进程是否应该常驻,再选择Type、退出判定与重启策略。短任务正常结束不应该被误当成必须立即重新执行的异常。systemd版本之间支持的选项存在差异,不能直接把最新手册中的所有参数复制到旧系统。
五、启动速率限制是保护信号
StartLimitIntervalSec和StartLimitBurst共同约束一定时间内的启动尝试。触发限制后,服务可能不再按原重启策略继续尝试。它解释的是为什么后续启动被拦住,不解释第一次失败的根因;无限提高次数或关闭限制,并不能修好应用。
reset-failed会清理失败状态,并可重置相关启动速率计数。它适合在问题已修复、准备恢复服务时按需使用,不是常态化“保活”办法。达到限制也不能简单理解为等待窗口结束后就必定自动恢复,仍应按单元行为和实际触发方式核对后续启动。
六、按最小变更恢复,而不是连续叠加操作
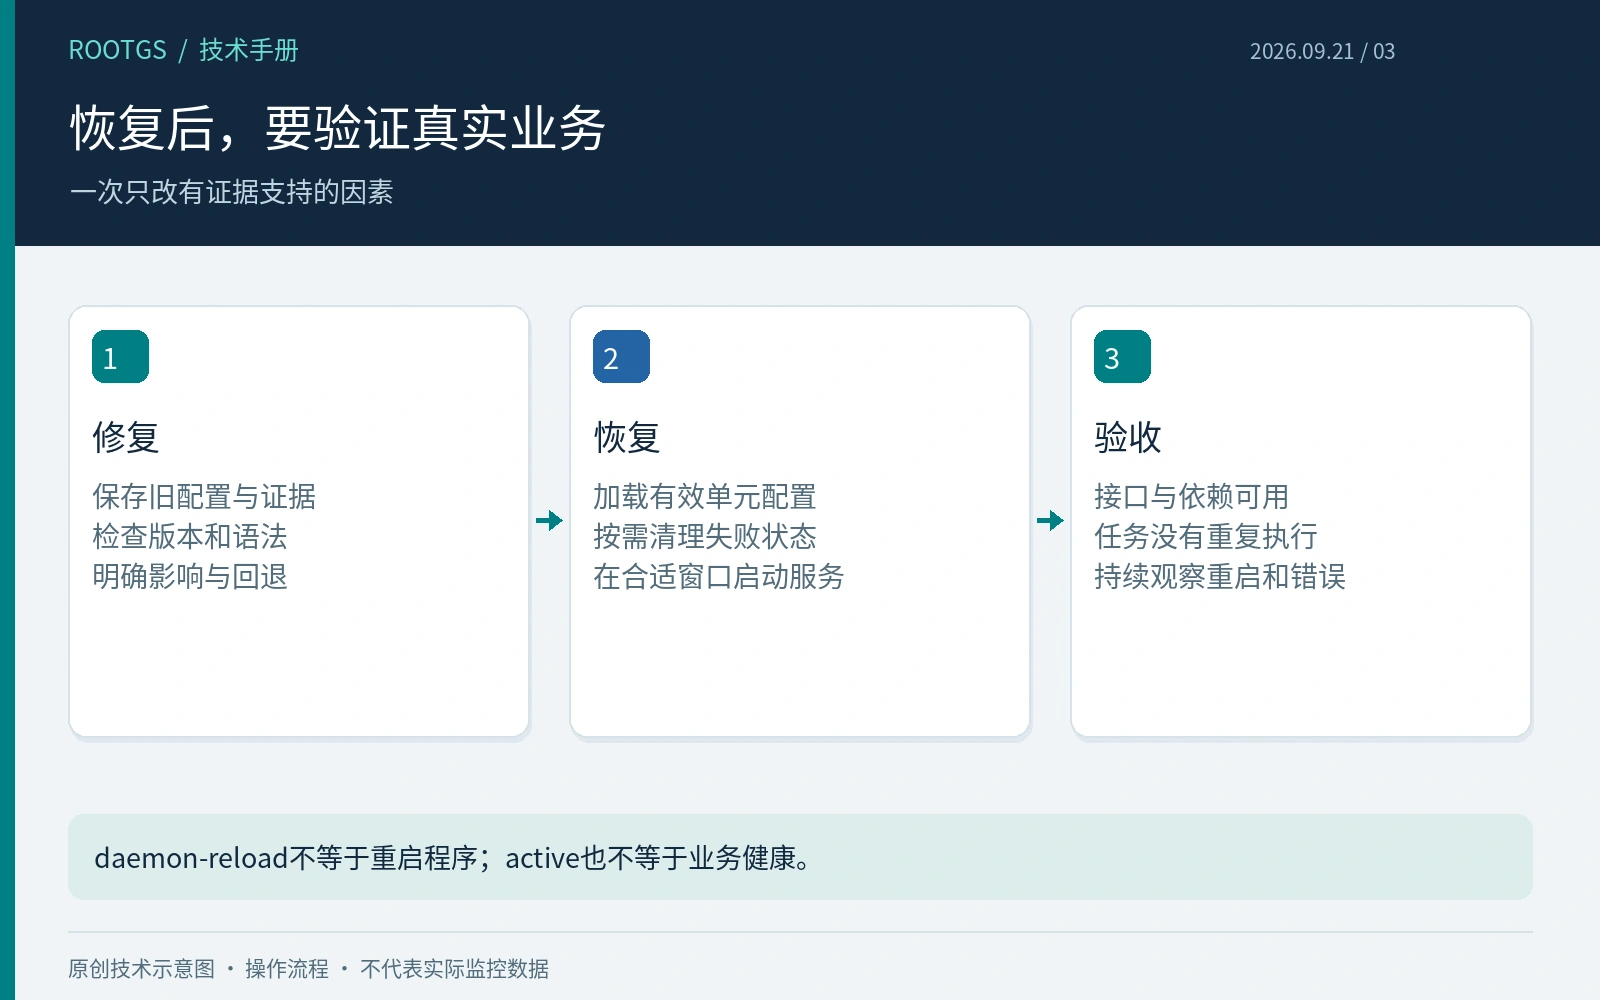
保存变更前配置,先修一个有证据支持的问题。例如修正错误工作目录后,再验证程序能否读取所需文件。修改单元文件后,需要让管理器重新加载配置;这一步与重启应用不同,不能把daemon-reload当成已经重新运行程序。
确认语法与依赖条件后,在适当维护窗口执行恢复操作。服务中断和重启会影响用户,应结合业务安排。若涉及数据库迁移、队列消费或定时任务,还需防止重复处理。恢复期间保留明确的回退路径,避免每失败一次就同时修改账号、权限、端口和重启策略。
七、active不是最终验收标准
进程存在不代表接口已经准备好,也不代表能读写依赖。验收应包含业务健康检查、代表性请求、后台任务与持续观察。把重启次数、错误日志和关键业务指标放在同一时间线上,确认问题不会在下一次依赖波动或流量高峰立即重现。
最后记录根因、变更、恢复时间和复发检测方式。对可预期的临时故障设计适当退避与告警,对不可恢复的配置错误让信息足够清楚。好的自动重启策略可以改善恢复速度,但前提是它没有掩盖持续失败,也没有把一次故障变成反复冲击业务的循环。
