
发布日期:2026 年 9 月 22 日 · RootGS 技术编辑
应用突然提示无法连接数据库,但数据库CPU并不高;重启应用后短暂恢复,过一会儿又出现相同问题。连接耗尽不一定意味着数据库需要更大机器,也可能是多个连接池叠加、连接泄漏、请求排队或事务没有及时结束。本文把连接容量与查询性能分开讨论,给出尽量少暴露业务数据的观察方法,以及一次调整应该怎样验收。
一、先确认拒绝发生在数据库还是连接池
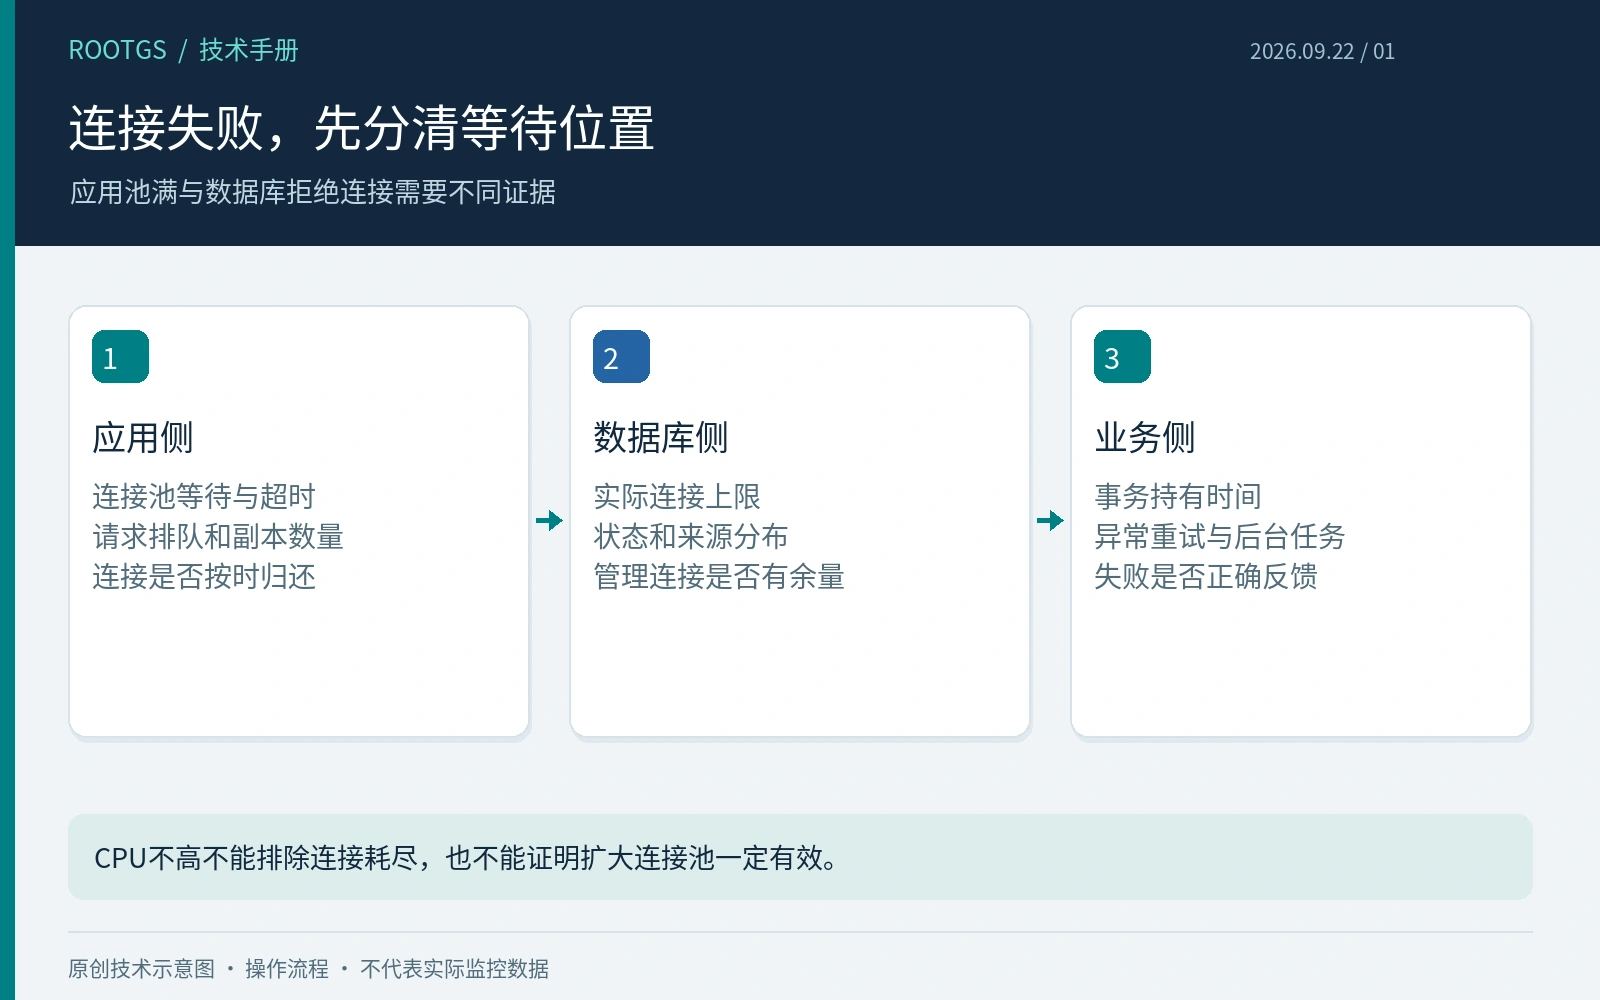
应用连接池获取连接超时,与PostgreSQL拒绝新增连接不是同一件事。前者可能在请求尚未建立新连接之前发生,后者则需要查看数据库返回的具体错误。记录错误时间、应用实例、连接池状态及数据库日志,避免只凭一条“连接失败”就调整服务器上限。
数据库还可能为特定角色或管理操作保留连接空间,不同版本的机制需按实际文档核对。诊断时不要把所有剩余位置都占满,应保留必要的管理路径。不要通过连续重启全部应用来试图腾空连接,这可能形成更集中的重连冲击。
二、连接预算要累计所有实例和进程
一个应用实例允许的连接池大小,乘上副本数、工作进程数和独立池数量后,才接近其最大连接需求。后台任务、定时作业、管理工具和迁移程序也会使用连接。只看单个配置文件里的一个数字,容易漏掉多进程或多个服务同时创建的池。
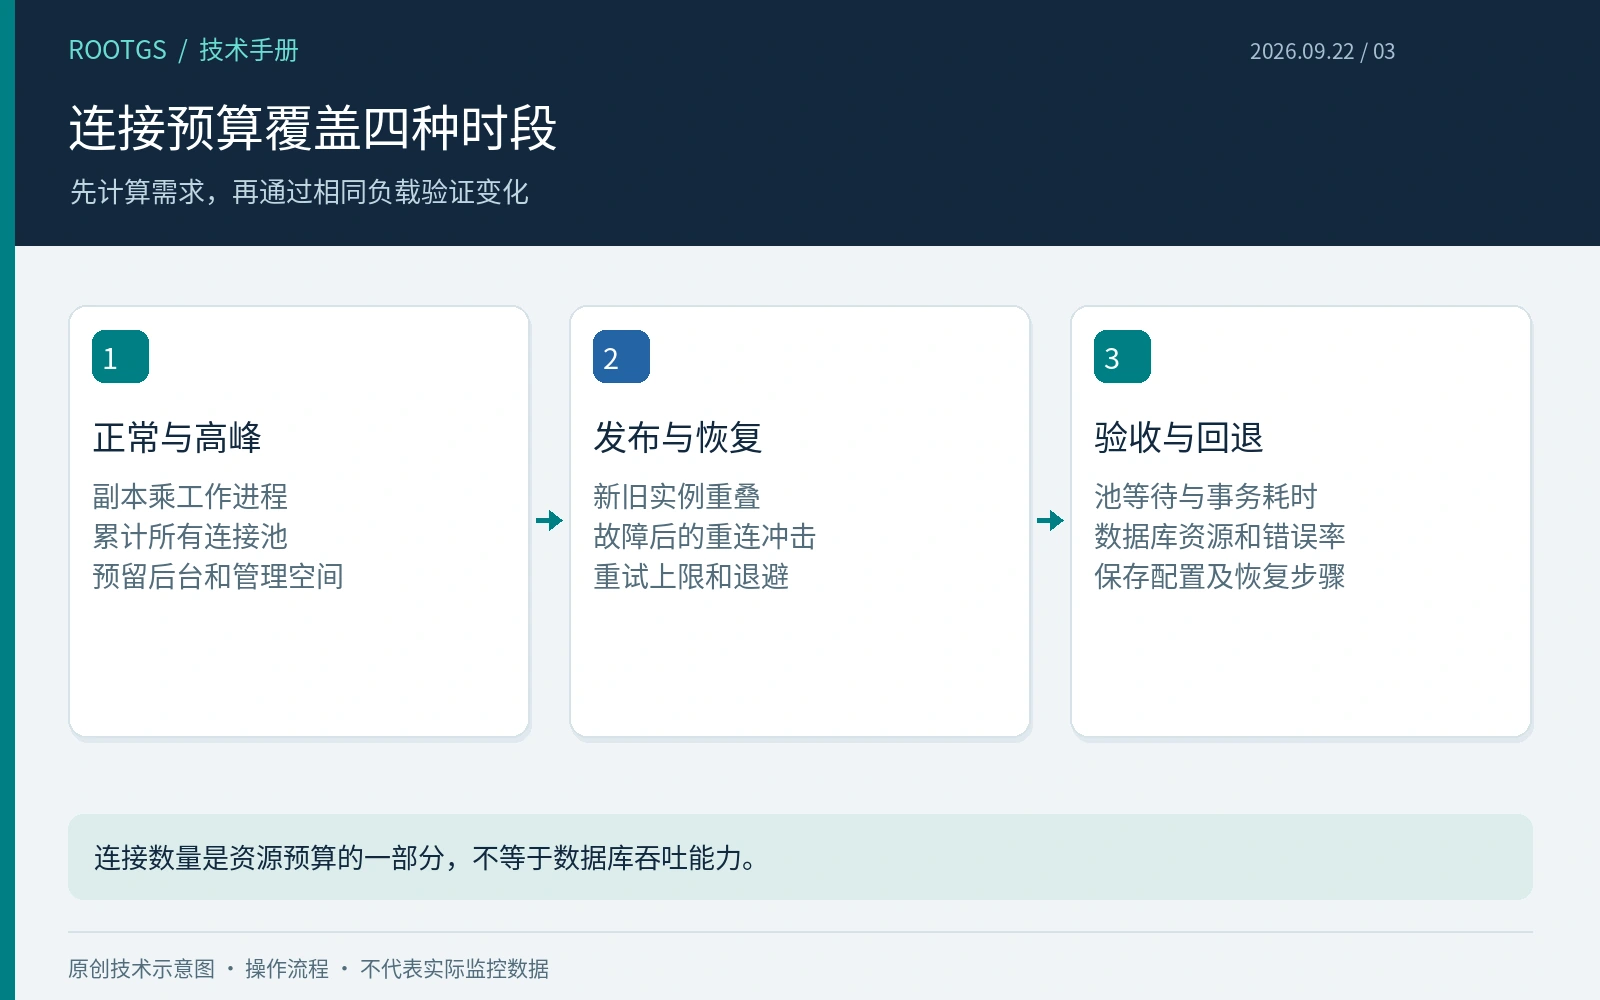
可建立连接预算表,分别列出正常运行、发布时新旧副本重叠、故障重试和批量任务期间的需求,并预留运维空间。预算只是上界估算,还要观察实际利用率。连接数增加并不直接创造数据库处理能力,可能反而带来更多竞争与等待。
三、先做聚合观察,再定位具体会话
可以通过已有的受控管理连接查询当前配置和活动状态。下面的聚合示例不输出SQL正文,便于先确定来源和状态分布;查询者仍需具备适当权限,不能为了排查临时公开数据库端口。
SHOW max_connections;
SELECT datname, application_name, state, count(*) AS connections
FROM pg_stat_activity
WHERE backend_type = 'client backend'
GROUP BY datname, application_name, state
ORDER BY connections DESC;
application_name可能未设置,或被多个程序共用,因此只能作为线索。某些监控字段与可见范围受版本和权限影响,应以本机为准。需要查看查询文本时只提取必要内容,避免把客户数据、字面量参数或认证信息复制进公开工单。
四、idle和idle in transaction的风险不同
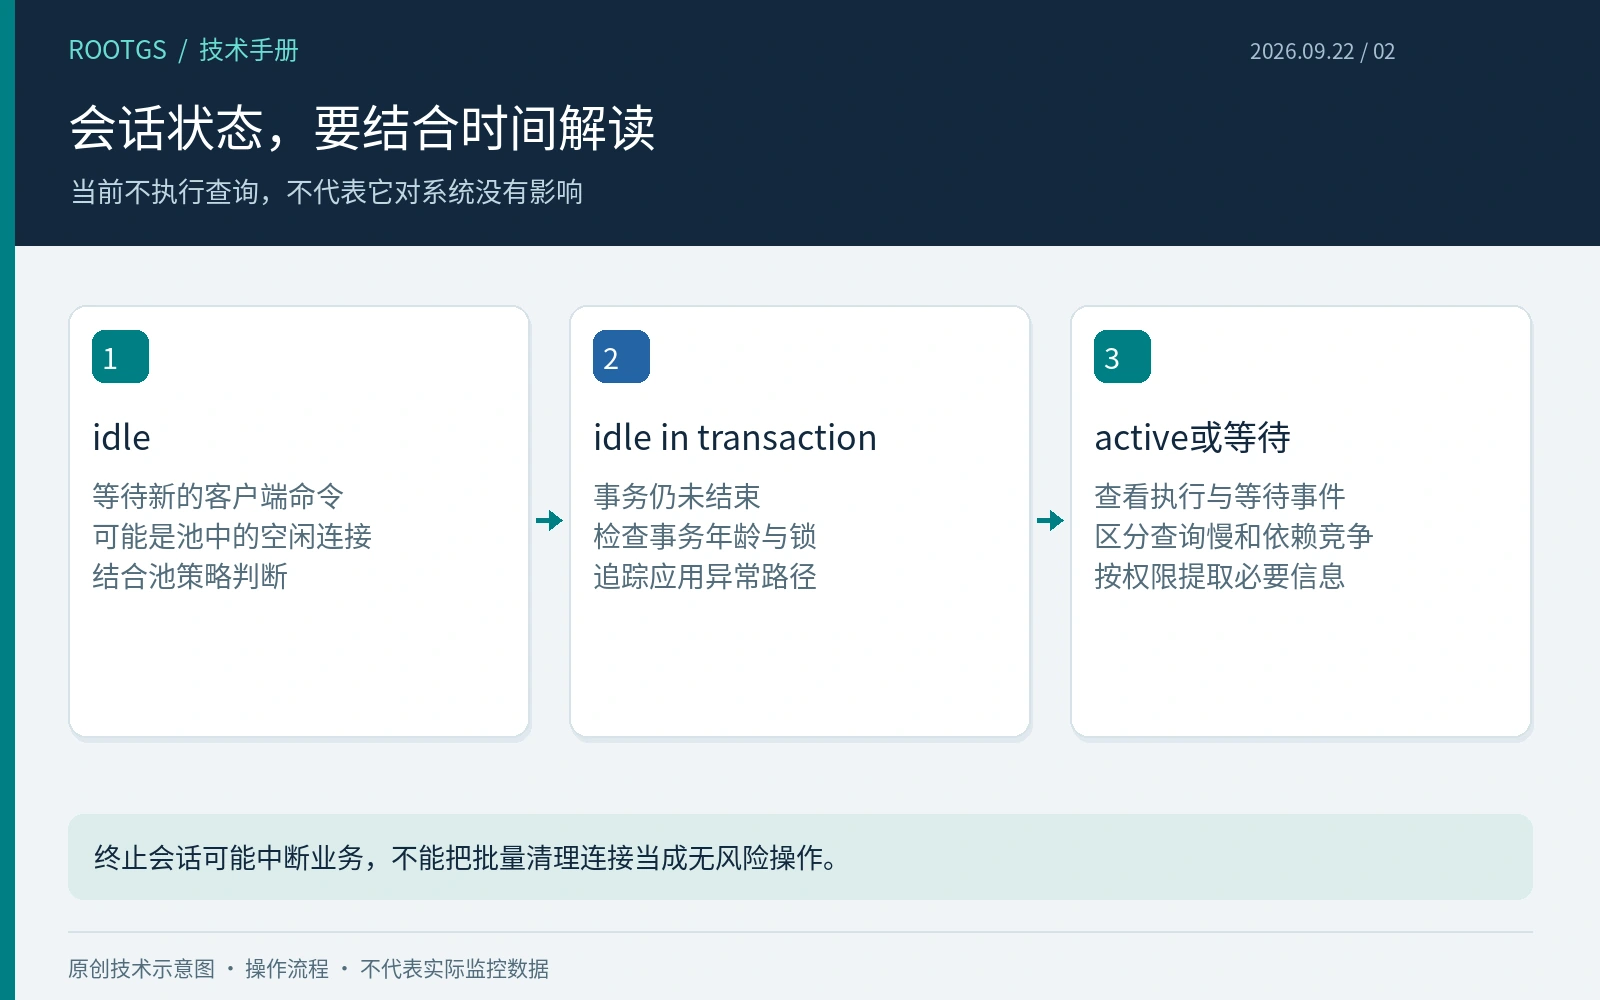
idle通常表示连接正在等待客户端的新命令,并不自动代表泄漏;连接池保留一定空闲连接可能是正常行为。idle in transaction则表示事务尚未结束但当前没有执行查询,需要结合事务开始时间、应用调用链及锁等待检查。
长时间未结束的事务可能影响锁释放和旧版本数据清理,问题不能仅用“这个连接现在没有CPU消耗”排除。观察state_change、xact_start和等待事件时应理解各自含义:状态持续时间、事务持续时间和最近查询开始时间并不是同一个时钟。
发现可疑会话后先确认归属和业务影响。终止连接会中断工作并可能触发回滚,不能把批量杀掉所有空闲会话作为无风险操作。
五、连接池应控制排队,而不是无限放大
池过小可能使应用等待,池过大则可能把数据库推入过量并发。需要同时观察获取连接耗时、执行耗时、事务持有时间和错误率,找到真正占用连接的阶段。业务处理、远程接口调用或用户等待若发生在事务内,连接可能长时间无法释放。
若使用外部连接池,还需核对池化模式与会话级特性的兼容性,不能默认所有临时状态、预处理行为或事务用法都能原样迁移。调整连接归还和超时策略时,要验证异常路径也会正确清理资源,而不是仅验证正常请求。
六、增加max_connections之前先评估代价
PostgreSQL会根据max_connections配置部分资源,提高它可能增加共享内存等资源需求,且该设置需要在服务器启动时生效。更高上限也可能让更多重查询同时竞争CPU、内存和存储,不能把它当成立即生效且没有成本的参数。
若证据表明合法连接需求确实超过合理预算,应在评估资源、备用节点配置和维护窗口后再变更。与此同时控制客户端的重试节奏,避免数据库恢复时所有实例同时建立最大数量连接。重试应有明确上限和错误反馈,不能让用户请求无限堆积。
七、用业务高峰和发布场景验证结果
复测时保持代表性查询、事务长度和并发模型,比较连接池等待、数据库连接分布、关键接口延迟及错误率。还要测试新旧应用实例同时存在的发布窗口,以及一个依赖故障后客户端恢复的过程。平峰连续运行正常,不足以证明连接预算已经覆盖这些场景。
记录调整前后的池配置、数据库上限、应用版本和回退条件。最终目标不是让连接数量看起来更少,而是让连接需求有边界、事务及时结束、失败可控,并在需要排错时仍保留可用的管理入口。
