
发布日期:2026 年 9 月 22 日 · RootGS 技术编辑
图像识别、生成和批量处理并不只消耗GPU。下载素材、解码、预处理、排队与结果上传也可能占据大量时间。香港物理机分类提供AMD与Intel CPU平台的GPU产品,但名称中的CPU品牌不能用来推断显卡品牌、显存或数量,选购时必须单独确认GPU配置。
一、当前分类与配置核对
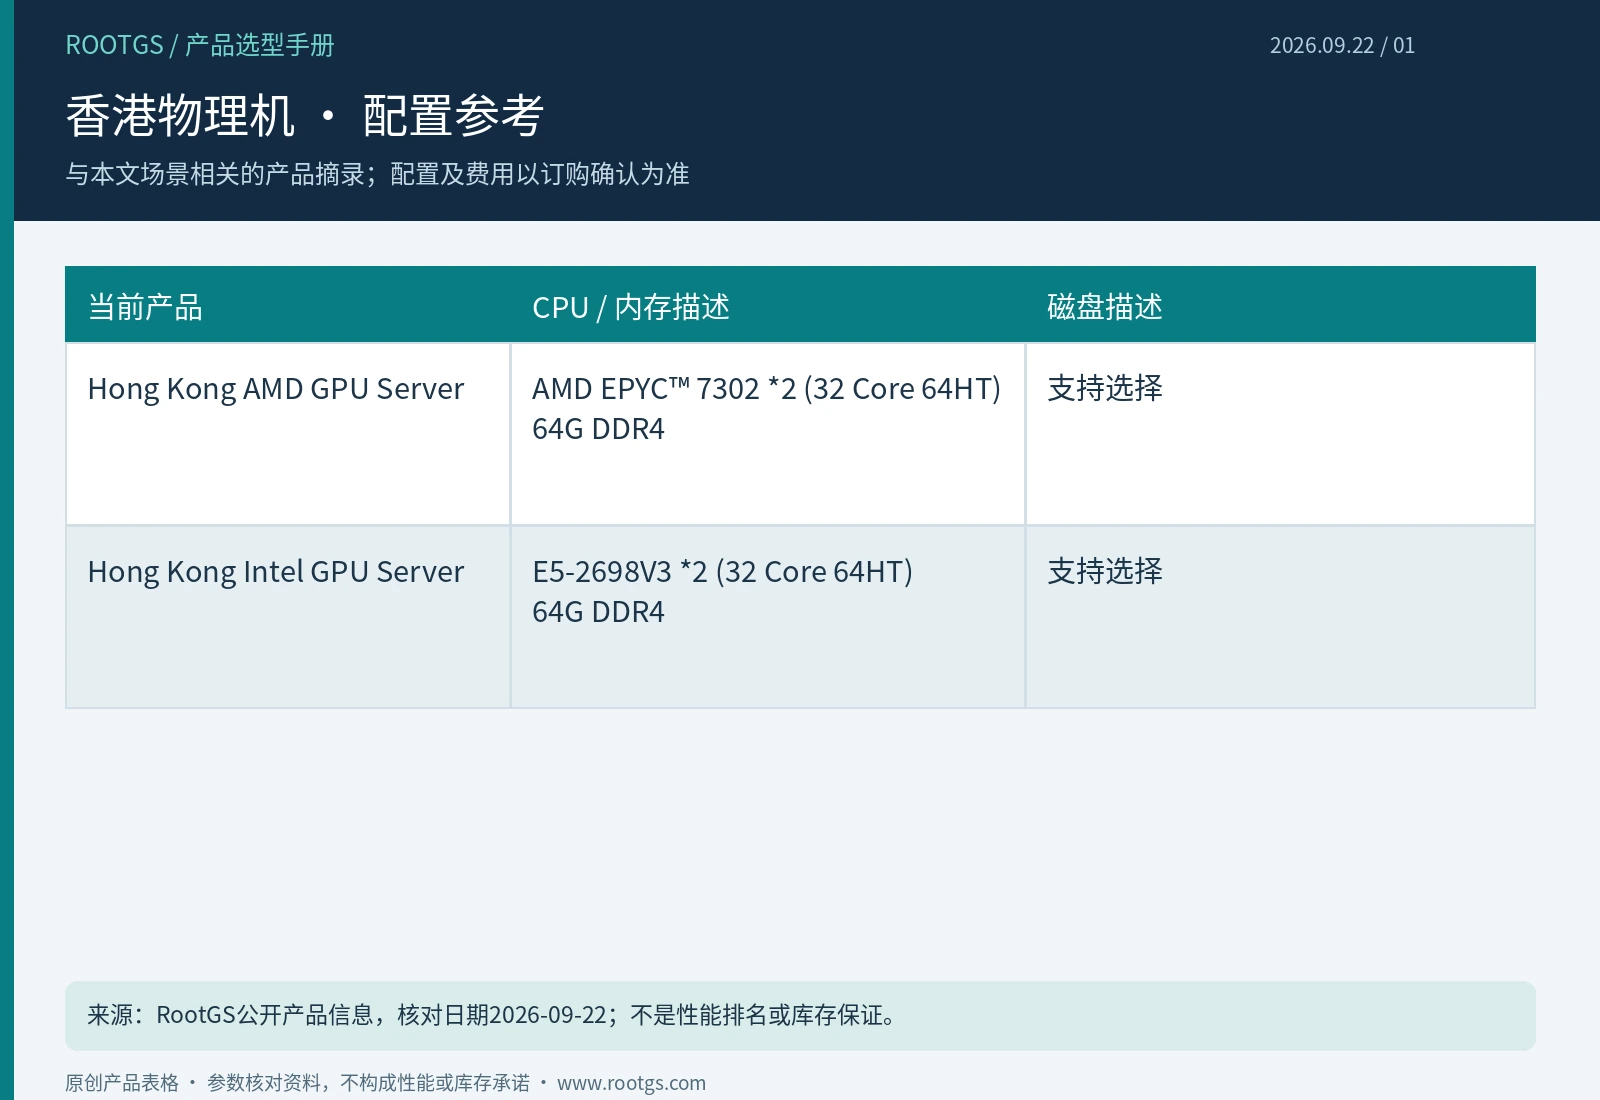
香港物理机同时有通用CPU、大内存和GPU候选,硬件用途差异较大。本文表格是与本场景相关的配置摘录,不是性能排名。磁盘“支持选择”、内网与防护选项需要在订购时确认;GPU产品还应单独核对显卡型号、显存和数量,不从CPU名称推断。交付范围、可用配置和费用以最终确认结果为准。
| 当前产品 | CPU / 内存描述 | 磁盘描述 |
|---|---|---|
| Hong Kong AMD GPU Server | AMD EPYC™ 7302 *2 (32 Core 64HT) 64G DDR4 | 支持选择 |
| Hong Kong Intel GPU Server | E5-2698V3 *2 (32 Core 64HT) 64G DDR4 | 支持选择 |
二、先固定模型与输入规格
同一模型在不同分辨率、批大小和附加模块下可能有完全不同的显存峰值。准备真实业务中具有代表性的合成输入,固定模型版本、精度和输出设置,再测单任务与并发。产品列表只展示CPU、基础内存和选配概况,实际显卡配置以订购页确认结果为准。不要把能够加载模型等同于完整工作流可以长时间稳定运行。
三、让CPU和存储为GPU持续供料
双路EPYC或E5平台可以承担不同的数据准备任务,但预处理能力仍需实测。若素材来自远端存储,网络下载和小文件访问会影响队列;若结果体积大,还要考虑写入和上传预算。可将待处理、处理中和已完成数据分开管理,给失败任务设置保留及清理策略。系统内存可以帮助缓存,不能直接变成GPU显存。
四、队列服务必须控制容量与失败
限制同时进入GPU的任务数量,并根据实测峰值设置合理批量。请求超时不一定代表任务没有执行,应让客户端能查询任务状态,避免重复生成和重复收费。升级模型前用固定样本比较质量、时间和显存;回退要同时保留兼容的运行环境。验收既要看成功任务,也要看显存不足、素材损坏和重启后任务如何恢复。
场景核对示例
例如,图像任务变慢时,可分别记录下载、解码、GPU计算和上传结果的耗时。如果GPU经常等待输入,先优化数据供给;如果显存峰值接近可用量,则评估批大小或模型设置。测试结果必须注明分辨率、模型版本、精度和并发,否则一个看似漂亮的耗时没有比较意义。上线限额应建立在已验证的完整流程上。
五、采购与验收对照表
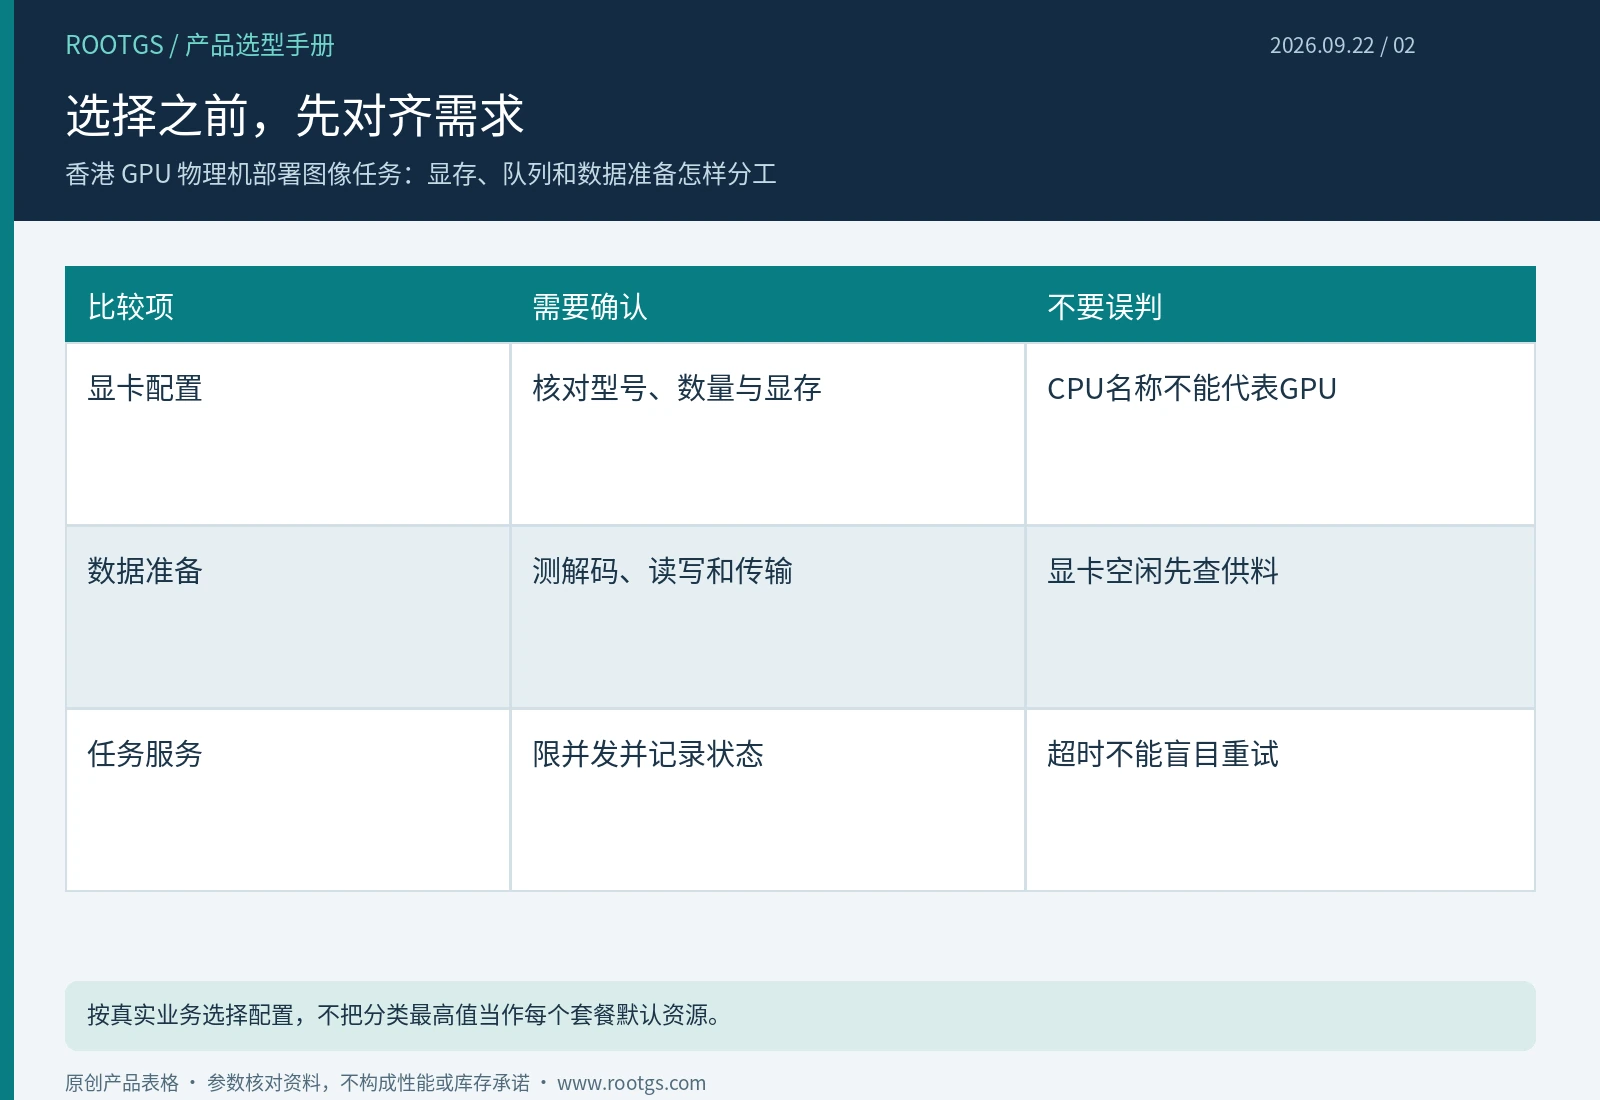
| 需求项 | 确认方式 | 容易忽略的边界 |
|---|---|---|
| 显卡配置 | 核对型号、数量与显存 | CPU名称不能代表GPU |
| 数据准备 | 测解码、读写和传输 | 显卡空闲先查供料 |
| 任务服务 | 限并发并记录状态 | 超时不能盲目重试 |
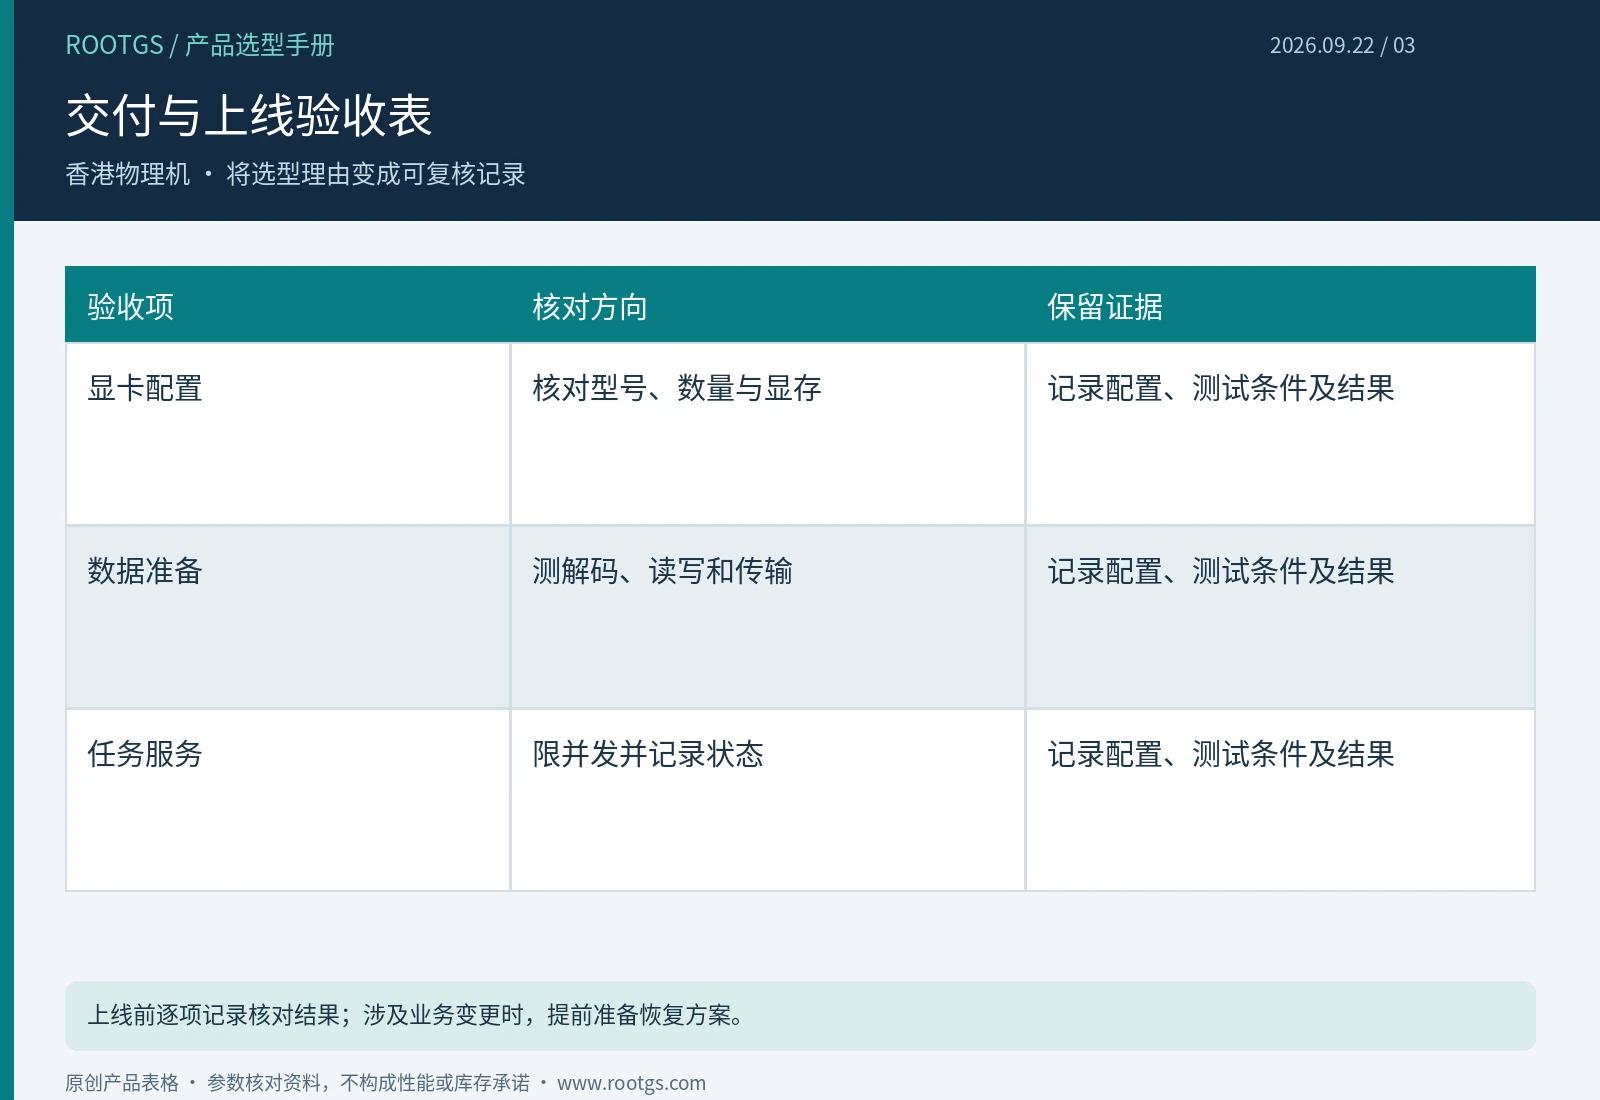
下单沟通时,可以把上表和代表性业务样例一起提供,并区分必须具备的能力与可以后续增加的选项。交付后保存实际配置、软件版本、测试输入和观察结果;对涉及停机、数据迁移或外部调用的验证,先安排合适窗口或测试替身。没有实际测试时应保留待确认项,不把理论配置换算成用户数、吞吐或延迟保证。
六、选择产品并准备上线资料
如果上述场景与当前业务相符,可进入对应产品分类查看可选组合,再用自己的输入规模、数据量和客户网络验证。采购需求应写明关键资源、可接受维护窗口及恢复目标;不要只写“配置越高越好”。产品页面会更新,文中配置摘录用于帮助理解选择方法,最终配置、费用、交付与可用性以订购确认结果为准。
